






python 的 enumerate() 在遍历时产出“序号、元素”二元组,默认序号从 0 开始,start 参数可改成 1 或其他整数。start 只改变返回的编号,不改变原列表的下标。需要边遍历边显示行号、排名或处理序号时,可直接解包这两个值。
在循环中同时取得零起始序号和元素
下面代码可直接执行。列表按顺序遍历,默认编号恰好与当前列表下标一致;遇到空列表则没有迭代结果,不需要特殊分支。enumerate 也可以处理其他可迭代对象,不要求对象有 len 方法。
fruits = ["apple", "banana", "orange"]
pairs = list(enumerate(fruits))
assert pairs == [(0, "apple"), (1, "banana"), (2, "orange")]
for index, fruit in enumerate(fruits):
    assert fruits[index] == fruit
    print(index, fruit)
assert list(enumerate([])) == []
如果只需要元素本身,直接 for fruit in fruits 更清楚;需要序号时才增加 enumerate,不必为了形式统一而在每个循环中创建编号。
从一或一百开始编号,但不把编号当数组下标
报告通常从 1 开始编号,已有记录可以从其他整数续号。下面的 start=100 不会让列表突然具有第 100 个元素,也不会改变原来的元素顺序。

items = ["first", "second", "third"]
assert list(enumerate(items, start=1)) == [(1, "first"), (2, "second"), (3, "third")]
assert list(enumerate(items, start=100)) == [(100, "first"), (101, "second"), (102, "third")]
for number, item in enumerate(items, start=100):
    print(f"编号 {number}:{item}")
assert items[0] == "first"
起点可以是整数负值,但编号含义仍由业务定义。对经过筛选或切片的数据重新 enumerate,得到的是本次遍历编号,不应被当成原数据的稳定身份标识。
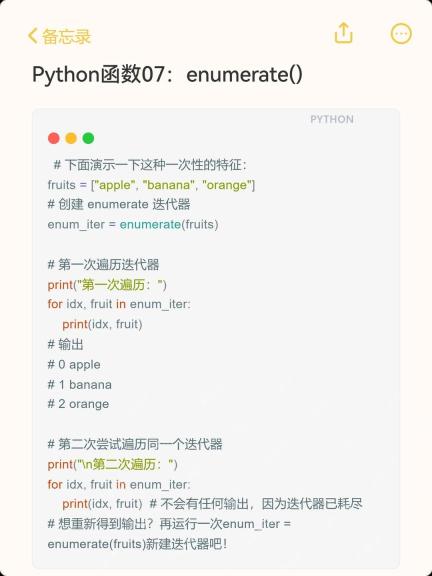
确认 enumerate 返回的迭代器只能消耗一次
enumerate 按需取得元素,不会先把源迭代器全部变成列表。下例用生成器展示消费顺序;再次使用同一个已经耗尽的 enumerate 不会重新开始。
seen = []
def source():
    for value in ["x", "y"]:
        seen.append(value)
        yield value

iterator = enumerate(source(), start=1)
assert seen == []
assert next(iterator) == (1, "x")
assert seen == ["x"]
assert list(iterator) == [(2, "y")]
assert list(iterator) == []
print("按需获取与迭代器耗尽检查通过")
若要重复遍历,重新创建源与 enumerate,或在数据量可控时保存结果。遍历过程中随意增删原列表会使编号与元素变化难以追踪,应先明确修改规则。
Python免费学习笔记(深入):立即使用
在学习笔记中,你将探索 Python 的核心概念和高级技巧!


