






在 nginx 中,默认的 upstream 轮询(round robin)算法本身并不具备自动剔除故障节点的能力,它会将请求持续发送给已标记为 down 或宕机的后端服务器,导致单点故障。要避免这个问题,必须结合健康检查机制:要么使用第三方模块(如 nginx_upstream_check_module)实现主动探测,要么依赖后端服务配合 keepalive 连接超时与重试逻辑,或者采用更高级的负载均衡策略(如 least_conn)配合被动故障检测。
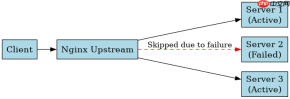
如何配置被动健康检查以自动剔除故障节点
通过设置 proxy_next_upstream 和 max_fails/fail_timeout 参数,Nginx 可以在一定时间内连续失败后自动将节点标记为不可用,从而实现被动的故障转移。

upstream backend {
    server 192.168.1.10:8080 max_fails=3 fail_timeout=30s;
    server 192.168.1.11:8080 max_fails=3 fail_timeout=30s;
    server 192.168.1.12:8080 max_fails=3 fail_timeout=30s;
}

server {
    listen 80;
    location / {
        proxy_pass http://backend;
        proxy_next_upstream error timeout invalid_header http_500 http_502 http_503;
    }
}
上述配置中,每个后端服务器在 30 秒内若连续发生 3 次失败(由 proxy_next_upstream 定义的错误类型触发),则会被暂时从上游列表中移除 30 秒。在此期间,新请求将仅分配给其他存活节点。当时间过后,Nginx 会尝试再次向该节点发送请求,若成功则重新加入池。这种方式无需额外模块,适用于大多数标准 Nginx 安装场景。
如何实现主动健康检查以确保快速故障切换
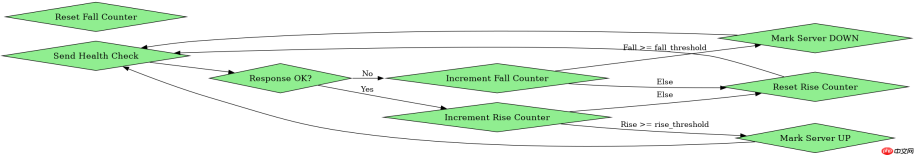
被动检查存在延迟,因为只有在请求到达故障节点时才会发现异常。为实现更快的故障识别,可使用 ngx_http_upstream_check_module 等第三方模块进行主动探测。

# 假设已编译支持 check 模块的 Nginx
upstream backend {
    server 192.168.1.10:8080;
    server 192.168.1.11:8080;
    server 192.168.1.12:8080;

    # 主动健康检查配置
    check interval=3000 rise=2 fall=3 timeout=1000 type=http;
    check_http_send "HEAD /health HTTP/1.0\r\n\r\n";
    check_http_expect_alive http_2xx http_3xx;
}
在此配置中,Nginx 每 3 秒(interval=3000ms)向每个后端发起一次 HTTP HEAD 请求至 /health 路径。若连续 2 次成功响应(rise=2),则标记节点为 UP;若连续 3 次失败(fall=3),则标记为 DOWN。超时时间为 1 秒。这种主动探测能显著缩短故障检测时间,避免大量请求被发送到已宕机节点。注意:此模块非官方内置,需自行编译或使用特定发行版(如 Tengine)。
当所有后端节点均被标记为 DOWN 时 Nginx 的行为是什么
如果所有上游服务器都因连续失败而被标记为 DOWN,Nginx 默认不会继续尝试任何请求,而是直接返回 502 Bad Gateway 错误。这是为了防止无限重试导致的资源耗尽或服务雪崩。
在上述两种配置模式下,一旦所有节点均进入 fail_timeout 周期或被主动检查判定为 DOWN,proxy_next_upstream 将不再生效,因为没有可用目标。此时客户端将收到标准的 502 响应。为避免此情况,建议至少保留一个备用节点,并监控 health 端点的可用性。此外,可结合 proxy_next_upstream_tries 限制最大重试次数,防止循环重试。例如,设置 proxy_next_upstream_tries 2 表示最多尝试两个不同节点,若仍失败则立即返回错误。这有助于控制故障影响范围,提升系统韧性。





