






nginx 的 upstream 模块本身不具备直接记录节点故障日志的功能,因为 nginx 的核心设计是高性能转发而非应用层审计。要实现这一需求,必须借助第三方模块 nginx_upstream_check_module(或类似功能的商业/开源插件)来主动探测后端健康状态,并结合 nginx 的 access_log 或 error_log 机制进行记录。具体做法是在配置中启用健康检查指令,定义检查间隔和超时时间,然后利用 nginx 的全局日志配置,将包含特定错误码或自定义变量的访问日志输出到独立文件,从而在流量层面间接反映节点异常。
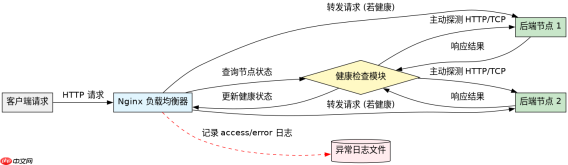
如何配置主动健康检查以触发异常判定
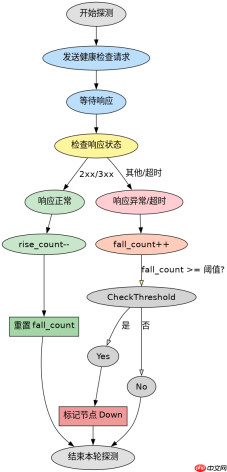
要记录节点异常,首先需要让 Nginx 知道哪些节点是异常的。这通过 check 指令实现。该指令允许你定义 HTTP 或 TCP 级别的主动探测。当探测失败次数超过阈值时,Nginx 会将该节点标记为 down,并在后续请求中将其剔除。配置的关键在于设置 interval(探测间隔)、timeout(超时时间)以及 fall(连续失败几次标记为不可用)和 rise(连续成功几次恢复可用)。例如,配置每 5 秒探测一次,超时 2 秒,连续失败 3 次则标记节点为异常。这样,Nginx 内部的状态机就会更新节点的健康状况,这是记录日志的前提。
upstream backend {
    server 192.168.1.10:80;
    server 192.168.1.11:80;

    # 启用主动健康检查
    check interval=5000 rise=3 fall=3 timeout=2000 type=http;
    check_http_send "GET /health HTTP/1.0\r\nHost: example.com\r\n\r\n";
    check_http_expect_alive http_2xx http_3xx;
}
上述配置中,check_http_send 指定了发送的健康检查请求,通常指向一个轻量级的 /health 接口。check_http_expect_alive 定义了哪些 HTTP 状态码被视为成功。如果后端返回非 2xx/3xx 状态码或连接超时,Nginx 会累加失败计数。一旦达到 fall 设定的值,节点即被判定为异常。此时,Nginx 不再向该节点分发新请求,但现有的长连接可能仍会尝试使用,直到连接关闭。这种状态切换是后续日志记录的基础。
如何将节点异常状态关联到访问日志
Nginx 原生日志格式中并没有直接的“节点健康状态”字段,但我们可以通过自定义 log_format 和利用变量来实现近似记录。一种常见的方法是结合 $upstream_status 和 $upstream_addr 变量。当节点被标记为 down 后,Nginx 通常会尝试下一个可用节点,或者如果所有节点都不可用,则返回 502 Bad Gateway。我们可以通过监控返回 502 且 $upstream_addr 中包含已标记节点的地址,来推断异常。更精确的做法是使用 nginx_upstream_check_module 提供的 $upstream_check_status 变量(如果模块版本支持),或者通过 Lua 脚本(如 OpenResty)获取实时健康状态并写入日志。在没有 Lua 的情况下,最可靠的方式是分析 error_log,因为当 Nginx 无法连接到被标记为 down 的节点(例如在状态切换瞬间)时,会记录 connect() failed (111: Connection refused) 或类似的错误信息,其中包含了目标 IP 和端口。


# nginx.conf 中的 log_format 示例
log_format upstream_log '$remote_addr - $remote_user [$time_local] '
                        '"$request" $status $body_bytes_sent '
                        '"$http_referer" "$http_user_agent" '
                        'upstream_addr=$upstream_addr '
                        'upstream_status=$upstream_status '
                        'upstream_response_time=$upstream_response_time';

# 将日志输出到专用文件
access_log /var/log/nginx/upstream_access.log upstream_log;
通过上述配置,每次请求都会记录上游服务器的地址和状态。虽然这不能直接显示“节点 A 当前健康检查失败”,但它记录了实际发生错误的请求。结合系统层面的日志轮转和分析工具(如 ELK),可以筛选出频繁出现特定 IP 且状态为 502 或 504 的记录,从而定位异常节点。对于需要实时告警的场景,建议引入 OpenResty 并使用 ngx.shared.DICT 存储健康状态,并在每个请求中追加状态信息到日志,以实现更细粒度的追踪。
当所有上游节点均被标记为异常时 Nginx 的行为是什么
当所有配置的 upstream 节点都被健康检查模块标记为 down 时,Nginx 不会停止服务,而是会根据配置决定如何处理 incoming 请求。默认情况下,如果没有任何可用节点,Nginx 会立即返回 502 Bad Gateway 错误给客户端,而不会等待或重试。这是因为 Nginx 的路由逻辑在负载均衡阶段就发现没有符合条件的后端服务器。这种行为确保了快速失败,避免请求堆积导致 Nginx 自身资源耗尽。然而,如果配置了 keepalive 连接池,且池中仍有与已标记节点的活跃连接,这些现有连接可能会继续传输数据,直到连接自然关闭或超时。新建立的连接则会被直接拒绝。此外,如果使用了 fail_timeout 参数,Nginx 会在指定的时间内忽略被标记为失败的节点,即使健康检查尚未恢复其状态,这也是一种保护机制,防止对不稳定节点的频繁探测加剧负载。


