






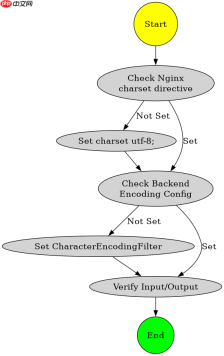
在 linux 中解决 nginx 请求头转发中文参数乱码,核心做法是确保上游应用(如 java spring boot)正确解码 utf-8 编码的请求体,并在 nginx 配置中显式声明字符集。具体而言,需要在 nginx 的 `location` 块或全局 `http` 块中添加 `charset utf-8;`,同时确保上游应用使用 `utf-8` 解码 `application/x-www-form-urlencoded` 或 `multipart/form-data` 类型的请求体。若上游应用未正确设置解码方式,nginx 仅负责透传,乱码问题通常源于应用层解析错误而非 nginx 本身。

Nginx 配置中 charset 指令的作用范围
Nginx 的 `charset` 指令主要用于控制响应内容的字符集,对请求头的转发影响有限,但能确保 Nginx 正确处理包含非 ASCII 字符的 URI 和日志记录。在实际部署中,建议在 `server` 或 `location` 块中显式设置 `charset utf-8;`,以避免浏览器或客户端因默认编码不一致导致的发送偏差。此外,Nginx 不会自动修改请求体的编码,它只是将原始字节流传递给上游服务器,因此上游应用的解码逻辑至关重要。
server {
    listen 80;
    server_name example.com;

    location /api/ {
        proxy_pass http://backend_app;
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto $scheme;

        # 关键配置:确保 Nginx 处理 UTF-8 编码的请求和响应
        charset utf-8;

        # 可选:强制客户端以 UTF-8 编码发送数据(需配合 HTTP/1.1)
        # 注意:这主要影响响应头 Content-Type,对请求体编码无直接控制力
    }
}
上述配置展示了 Nginx 作为反向代理时的基本结构。重点在于 `charset utf-8;` 的设置,它告诉 Nginx 在处理响应时使用 UTF-8 编码,同时也暗示了期望的请求编码格式。然而,真正的乱码修复往往需要在上游应用层面进行。例如,在 Java Spring Boot 应用中,可以通过配置 `CharacterEncodingFilter` 来强制所有请求和响应使用 UTF-8 编码。以下是一个简单的 Spring Boot 过滤器配置示例:
@Component
public class EncodingFilter implements Filter {
    @Override
    public void doFilter(ServletRequest request, ServletResponse response, FilterChain chain)
            throws IOException, ServletException {
        request.setCharacterEncoding("UTF-8");
        response.setCharacterEncoding("UTF-8");
        chain.doFilter(request, response);
    }
}
该过滤器确保所有进入应用的请求都被正确解码为 UTF-8,从而避免中文参数出现乱码。结合 Nginx 的 `charset` 配置,可以形成一个完整的编码处理链路。

上游应用解码策略与常见陷阱
上游应用(如 Java、Python、Node.js)在接收请求时,必须明确指定解码字符集。常见的陷阱包括:框架默认使用 ISO-8859-1 解码、未设置 `Content-Type` 导致无法识别编码、以及表单提交时未指定 `charset` 属性。在 Java Spring Boot 中,除了上述过滤器,还可以在全局配置文件中设置 `server.servlet.encoding.charset=UTF-8`。对于 Python Flask 应用,可以使用 `app.config['JSON_AS_ASCII'] = False` 和 `request.get_data(as_text=True)` 来确保文本正确处理。Node.js Express 应用则依赖 `body-parser` 中间件,并设置 `{ type: '*/*', charset: 'utf-8' }`。

// Node.js Express 示例
const express = require('express');
const app = express();

// 配置 body-parser 以 UTF-8 解码所有请求体
app.use(express.json({ type: '*/*', charset: 'utf-8' }));
app.use(express.urlencoded({ extended: true, type: '*/*', charset: 'utf-8' }));

app.post('/api/data', (req, res) => {
    const { name } = req.body;
    // name 应为正确解码的中文字符串
    res.json({ receivedName: name });
});

app.listen(3000);
此 Node.js 示例展示了如何通过 `body-parser` 中间件强制解码 UTF-8 编码的请求体。关键在于 `charset: 'utf-8'` 参数的设置,它覆盖了默认的 ISO-8859-1 解码行为。当客户端发送包含中文的 JSON 或 URL 编码表单时,Express 应用将正确解析这些字符。若未设置此参数,中文可能会显示为乱码或问号。此外,还需确保客户端(如浏览器或 Postman)在发送请求时指定正确的 `Content-Type`,例如 `application/json; charset=utf-8` 或 `application/x-www-form-urlencoded; charset=utf-8`,以提示服务端使用正确的编码方式。
特定场景下请求头中中文参数的处理
在某些场景中,中文参数可能出现在请求头(Header)而非请求体(Body)中,例如自定义 Header `X-Custom-Param`。Nginx 默认会透传所有请求头,但若上游应用未正确解码,仍会出现乱码。此时,除了上游应用的解码配置外,还需确保客户端在发送请求头时已对中文进行 URL 编码(Percent-Encoding)。例如,中文“测试”应被编码为 `%E6%B5%8B%E8%AF%95`。Nginx 不会自动解码请求头中的百分号编码,因此上游应用必须手动解码。在 Java 中,可使用 `URLDecoder.decode(headerValue,





