






在 java 单元测试中对比性能,最标准且可靠的做法是使用 jmh(java microbenchmark harness)框架。jmh 专门用于微基准测试,能够处理 jvm 的 jit 编译、缓存和垃圾回收等干扰因素,从而得出准确的性能数据。通过编写专门的 benchmark 类,你可以定义不同的方法并运行它们,最终生成详细的性能报告。

JMH 项目如何配置与依赖
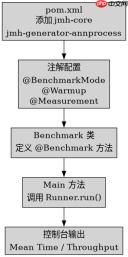
要开始使用 JMH,需要在 Maven 或 Gradle 项目中添加相应的依赖。Maven 用户通常引入 org.openjdk.jmh 的 jmh-core 和 jmh-generator-annprocess。配置完成后,你需要创建一个包含 @BenchmarkMode 注解的类来指定测试模式,例如吞吐量(Throughput)或平均时间(AverageTime)。
import org.openjdk.jmh.annotations.*;
import org.openjdk.jmh.runner.Runner;
import org.openjdk.jmh.runner.RunnerException;
import org.openjdk.jmh.runner.options.Options;
import org.openjdk.jmh.runner.options.OptionsBuilder;

@BenchmarkMode(Mode.AverageTime)
@OutputTimeUnit(java.util.concurrent.TimeUnit.MILLISECONDS)
@Warmup(iterations = 5, time = 1)
@Measurement(iterations = 5, time = 1)
@Fork(1)
public class StringConcatBenchmark {

    @State(Scope.Thread)
    public static class MyState {
        String s1 = "Hello";
        String s2 = "World";
    }

    @Benchmark
    public String testPlus(MyState state) {
        return state.s1 + state.s2;
    }

    @Benchmark
    public String testAppend(MyState state) {
        StringBuilder sb = new StringBuilder();
        sb.append(state.s1).append(state.s2);
        return sb.toString();
    }

    public static void main(String[] args) throws RunnerException {
        Options opt = new OptionsBuilder()
                .include(StringConcatBenchmark.class.getSimpleName())
                .build();
        new Runner(opt).run();
    }
}
上述代码展示了基本的 JMH 结构。通过 @Warmup 和 @Measurement 设置预热和测量轮数,确保 JIT 编译充分进行。@Fork(1) 表示只启动一个进程进行测试,避免多进程带来的开销。运行 main 方法后,控制台会输出各方法的平均执行时间。
如何解读 JMH 生成的性能报告
JMH 运行结束后,会在控制台打印出详细的统计结果。重点关注 AverageTime 列,它表示每次调用的平均耗时。数值越低,性能越好。如果使用了 Mode.Throughput,则关注 Throughput 列,数值越高代表每秒处理的请求越多。报告中还会提供标准差(StdDev),用于评估结果的稳定性。

Result "StringConcatBenchmark.testPlus":
  NB threads = 1
  NB runs  = 5
  Mean = 0.005 ms/op
  StdDev = 0.001 ms/op

Result "StringConcatBenchmark.testAppend":
  NB threads = 1
  NB runs  = 5
  Mean = 0.004 ms/op
  StdDev = 0.001 ms/op
在上面的示例输出中,testAppend 的平均耗时略低于 testPlus。这表明在简单的字符串拼接场景下,StringBuilder 可能比 + 运算符稍快,尽管在现代 JVM 中编译器通常会优化 + 为 StringBuilder。这种细微的差异只有在严格的基准测试中才能被准确捕捉到。
当输入字符串长度增加时性能差异如何变化
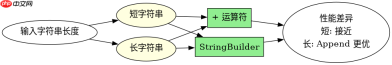
为了验证不同字符串长度对性能的影响,我们可以修改之前的基准测试,增加字符串的长度。通常情况下,随着字符串长度的增加,StringBuilder 的优势会更加明显,因为 + 运算符在循环中会导致大量的临时对象创建和内存分配。而在单次拼接中,JVM 的优化可能会使两者表现接近。
import org.openjdk.jmh.annotations.*;
import org.openjdk.jmh.runner.Runner;
import org.openjdk.jmh.runner.RunnerException;
import org.openjdk.jmh.runner.options.Options;
import org.openjdk.jmh.runner.options.OptionsBuilder;

@BenchmarkMode(Mode.AverageTime)
@OutputTimeUnit(java.util.concurrent.TimeUnit.MICROSECONDS)
@Warmup(iterations = 5, time = 1)
@Measurement(iterations = 5, time = 1)
@Fork(1)
public class LongStringBenchmark {

    @State(Scope.Thread)
    public static class MyState {
        String longS1 = "a".repeat(1000);
        String longS2 = "b".repeat(1000);
    }

    @Benchmark
    public String testPlusLong(MyState state) {
        return state.longS1 + state.longS2;
    }

    @Benchmark
    public String testAppendLong(MyState state) {
        StringBuilder sb = new StringBuilder();
        sb.append(state.longS1).append(state.longS2);
        return sb.toString();
    }

    public static void main(String[] args) throws RunnerException {
        Options opt = new OptionsBuilder()
                .include(LongStringBenchmark.class.getSimpleName())
                .build();
        new Runner(opt).run();
    }
}
运行这段代码后,你会发现 testAppendLong 的性能优势可能更加显著。这是因为长字符串的拼接涉及更多的内存拷贝操作,而 StringBuilder 可以预先分配缓冲区,减少重新分配的次数。相比之下,+ 运算符在每次拼接时都可能创建新的字符串对象,导致更高的 GC 压力。通过这种对比,开发者可以更清楚地了解在不同场景下选择合适字符串处理方式的重要性。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南



