






使用探索测试发现隐藏问题的核心做法是放弃预设的固定断言,改为在运行时动态生成大量随机输入并实时校验程序行为。具体实现时,需要引入如 junit 5 的 @parameterizedtest 结合自定义数据源,或者使用专门针对探索性测试的库(如 jqwik、archunit 或自研的随机生成器)。这样做能覆盖边界条件、异常路径和状态组合,从而暴露传统单元测试因用例设计局限而遗漏的逻辑缺陷。

如何构建支持随机输入的测试框架
要构建支持探索性测试的基础设施,关键在于定义数据的生成策略并将其与测试执行引擎解耦。通过创建一个通用的测试执行器,可以接收任意数量的随机样本,并在每次迭代中验证不变量(Invariants)或契约(Contracts)。这种方法允许开发者在不预先知道具体错误场景的情况下,通过大规模的数据投喂来“撞”出潜在问题。
import org.junit.jupiter.api.Test;
import org.junit.jupiter.params.ParameterizedTest;
import org.junit.jupiter.params.provider.MethodSource;
import java.util.stream.Stream;

public class ExploratoryTestExample {
    // 模拟一个复杂的业务逻辑类
    static class ComplexService {
        public String process(String input) {
            if (input == null || input.isEmpty()) return "EMPTY";
            if (input.length() > 100) return "TOO_LONG";
            if (input.contains("ERROR")) throw new RuntimeException("Bad Input");
            return input.toUpperCase();
        }
    }

    // 提供随机字符串生成源
    private static Stream<string> randomStrings() {
        return Stream.generate(() -> {
            int len = (int) (Math.random() * 150);
            StringBuilder sb = new StringBuilder();
            for (int i = 0; i  0.9) sb.insert(0, "ERROR");
            return sb.toString();
        }).limit(1000); // 运行1000次探索
    }

    @ParameterizedTest(name = "Exploring input: {0}")
    @MethodSource("randomStrings")
    void shouldHandleRandomInputs(String input) {
        ComplexService service = new ComplexService();
        try {
            String result = service.process(input);
            // 动态校验:如果返回非空且非特定状态码,长度应匹配
            if (!result.equals("EMPTY") && !result.equals("TOO_LONG")) {
                assert result.length() == input.length() :
                    "Length mismatch for: " + input;
            }
        } catch (RuntimeException e) {
            // 预期内异常处理
            assert input.startsWith("ERROR") :
                "Unexpected exception for: " + input;
        }
    }
}</string>
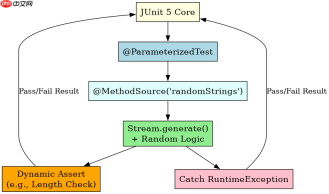
上述代码展示了如何通过 @ParameterizedTest 注入由 randomStrings 方法生成的数千个随机字符串。测试不再关注单一输入输出对,而是关注在整个输入空间内的行为一致性。例如,当输入包含 "ERROR" 时,程序抛出异常;否则,返回结果应为大写且长度一致。这种机制能有效发现如空指针、数组越界或逻辑分支遗漏等隐蔽问题。
如何利用不变量检测深层逻辑错误
除了随机输入,探索测试的高级用法是结合“不变量”检查。不变量是指在程序执行过程中始终为真的条件,例如排序后的列表第一个元素必须小于最后一个元素,或者经过序列化再反序列化的对象应与原对象相等。通过在测试循环中持续验证这些不变量,可以在不指定具体期望值的情况下捕捉到状态不一致或计算错误。


import org.junit.jupiter.api.Test;
import java.util.ArrayList;
import java.util.Collections;
import java.util.List;
import java.util.Random;

public class InvariantCheckTest {
    static class DataProcessor {
        List<integer> data = new ArrayList();

        public void add(int value) {
            data.add(value);
        }

        public List<integer> getSortedData() {
            List<integer> sorted = new ArrayList(data);
            Collections.sort(sorted);
            return sorted;
        }
    }

    @Test
    void shouldMaintainSortInvariant() {
        DataProcessor processor = new DataProcessor();
        Random rand = new Random(42); // 固定种子以便复现

        // 进行1000次随机添加操作
        for (int i = 0; i  sorted = processor.getSortedData();
            for (int j = 0; j  sorted.get(j + 1)) {
                    throw new AssertionError(
                        "Sort invariant violated at index " + j +
                        ": " + sorted.get(j) + " > " + sorted.get(j+1)
                    );
                }
            }
        }
    }
}</integer></integer></integer>
在这个示例中,DataProcessor 模拟了一个内部维护列表并对外提供排序视图的服务。测试通过不断添加随机整数,并在每一步调用 getSortedData() 后遍历检查相邻元素的大小关系。如果内部排序算法存在 bug(例如未处理重复元素或边界情况),这个不变量检查会立即抛出 AssertionError 并指出违反的位置。这种方式比传统的“给定-当-然后”模式更能发现累积性的状态错误。
如何处理探索测试中的非确定性失败
探索测试的一个主要挑战是非确定性:相同的测试代码在不同时间或不同机器上可能产生不同的随机输入,从而导致失败。为了有效利用这一工具,必须确保失败的测试是可复现的。最佳实践是在捕获失败时记录导致失败的随机种子(Seed)或具体的输入数据,以便后续将其转化为固定的单元测试。此外,对于某些资源密集型操作,应设置超时和内存限制,防止探索过程卡死或耗尽系统资源。
import org.junit.jupiter.api.Test;
import org.junit.jupiter.api.Assertions;
import java.util.Random;

public class ReproducibleFailureTest {
    @Test
    void testWithReproducibleSeed() {
        long seed = 12345L; // 从之前的失败日志中获取的种子
        Random rand = new Random(seed);

        // 使用相同种子重新生成相同的输入序列
        int input = rand.nextInt(100);

        // 假设这是之前失败的场景
        Assertions.assertNotEquals(50, input,
            "Failed with seed " + seed + ", input was " + input);
    }
}
当探索测试发现一个问题时,开发者应立即提取当前的随机种子或输入参数,如上例所示,将其硬编码到一个新的 @Test 方法中。这样既保留了探索测试的大规模覆盖能力,又确保了关键 Bug 有固定的回归测试用例。同时,建议在 CI/CD 流水线中对探索测试设置较短的运行时间或较少的迭代次数,而在本地开发环境中则允许更充分的探索,以平衡反馈速度与覆盖率。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


