






在 docker 中实时监控容器日志并触发报警,最稳健的做法是部署一个独立的日志采集 agent(如 filebeat、fluentd 或 vector),将其挂载到宿主机的日志目录或容器的标准输出流上。该 agent 负责实时读取 /var/lib/docker/containers/ 文件,解析 json 格式的日志内容,并根据预设的关键字(如 error、fatal)或正则表达式进行匹配。一旦命中规则,agent 会将告警事件转发至 slack、钉钉、企业微信或通过 webhook 调用 prometheus alertmanager 等通知渠道,从而实现从日志产生到告警触发的自动化闭环。

如何配置 Filebeat 实现日志的实时抓取与过滤
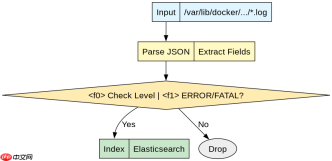
使用 Filebeat 作为日志采集器时,核心在于正确配置 filebeat.yml 以识别 Docker 日志路径并应用数据过滤。Filebeat 支持通过 docker 模块自动发现容器,或者手动指定 paths 来监控宿主机上的日志文件。为了减少无效数据的传输和降低误报率,必须在采集端完成初步的过滤,只保留包含特定错误级别的日志行。这通常通过配置 include_lines 或使用 Grok 模式来实现,确保只有符合预期的异常日志才会被送入下游处理环节。
filebeat.inputs:
- type: log
  paths:
    - /var/lib/docker/containers/*/*.log
  json.keys_under_root: true
  json.overwrite_keys: true
  include_lines: ['.*ERROR.*', '.*FATAL.*']

output.elasticsearch:
  hosts: ["localhost:9200"]
  index: "docker-logs-%{+yyyy.MM.dd}"
上述配置展示了如何监控所有容器的日志,并通过 include_lines 仅捕获包含 ERROR 或 FATAL 的行。启用 json.keys_under_root 可以将 JSON 日志中的字段提升到根层级,便于后续查询。运行此配置后,Filebeat 将启动并持续轮询日志文件的新增部分,将匹配到的日志条目发送至 Elasticsearch 存储,为后续的可视化或告警提供数据基础。
如何将采集到的日志接入 Prometheus 进行指标化监控
除了直接基于文本日志告警,更高级的做法是将日志转化为可度量的指标,利用 Prometheus 强大的告警引擎进行处理。这可以通过部署 prometheus-logstash-exporter 或使用 Fluent Bit 的 prometheus_remote_write 插件来实现。关键在于定义具体的“计数”逻辑,例如统计每分钟出现 500 Internal Server Error 的次数。当这个计数超过设定的阈值时,Prometheus 的规则引擎会触发告警状态,进而通知 Alertmanager。

「在我电脑上明明能跑」——因为少了Docker。帮你写Dockerfile、构建镜像、配置多环境、编排docker-compose,从本地开发到服务器部署一条龙。支持Node.js/Python/Go/Java/前端全栈,覆盖CI/CD集成、安全加固、监控告警,告别环境不一致的噩梦。 触发词:Docker部署、容...

# Fluent Bit Configuration Example
[SERVICE]
    Flush         1
    Daemon        Off

[INPUT]
    Name          tail
    Path          /var/lib/docker/containers/*/*.log
    Parser        docker
    Tag           docker.*

[FILTER]
    Name          parser
    Regex         (?<level>ERROR|WARN|INFO)
    Key_Name      log

[OUTPUT]
    Name          prometheus_remote_write
    Match         *
    Endpoint      http://prometheus:9090/api/v1/write
    Metric_Name   container_log_level_count
    Labels        container_name=${tag_parts[1]}</level>
这段 Fluent Bit 配置演示了如何将日志解析为指标。它首先通过 Tail 输入插件读取 Docker 日志,然后使用 Parser 过滤器提取日志级别(Level)。最后,Output 插件将这些信息转换为 Prometheus 格式的时间序列数据,发送到 Prometheus 服务端。在 Prometheus 侧,可以编写 PromQL 查询语句,如 sum(rate(container_log_level_count{level="ERROR"}[5m])) by (container_name),当该值大于 0 时即触发告警。这种方式的优势在于可以利用 Prometheus 的历史数据和聚合能力,实现更复杂的告警策略。
当容器日志中出现 OOMKilled 信号时系统应如何响应
针对内存溢出导致的 OOMKilled 这一具体场景,系统需要能够识别内核发出的终止信号并将其转化为高优先级告警。Docker 守护进程在检测到容器因内存超限而被 Linux 内核杀死时,会在日志中记录相关信息,或者更可靠地,通过 Docker 的事件系统(Event Stream)广播 die 事件,其中包含退出码 137(128 + 9 SIGKILL)。监控脚本或 Agent 应当订阅这些事件,而不仅仅是分析文本日志,因为文本日志可能存在延迟或缓冲问题。
// Go 示例:监听 Docker 事件并检测 OOMKilled
client, err := client.NewClientWithOpts(client.FromEnv, client.WithAPIVersionNegotiation())
if err != nil {
    panic(err)
}
ctx := context.Background()
msgCh, errCh := client.Events(ctx, types.EventsOptions{})
for msg := range msgCh {
    if msg.Status == "die" && msg.Actor.Attributes["oom"] == "true" {
        sendAlert(msg.Actor.ID, "Container OOMKilled")
    }
}
上述 Go 代码片段展示了如何通过 Docker SDK 实时监听事件流。当收到 die 状态的消息时,检查 oom 属性是否为 true。如果确认是 OOM 导致容器退出,立即调用 sendAlert 函数发送报警。这种方法比解析日志文件更及时、更准确,因为它直接利用了容器生命周期管理的底层机制,避免了日志写入延迟带来的漏报风险。


