






使用 fetch 发起请求后,通过 response.body.getreader() 获取原始字节流,利用 textdecoderstream 将其解码为文本,再配合自定义的 sseparsertransform 将连续的字符流按行切分并组装成完整的事件对象。这样做能直接处理底层数据,避免引入第三方库,同时确保在遇到网络波动或乱序时仍能正确解析出 data、event 和 id 字段。

如何构建可复用的 SSE 解析流
核心在于创建一个继承自 TransformStream 的类,它在 transform 方法中维护一个缓冲区,逐字接收来自 ReadableStream 的数据,并在检测到换行符时触发事件发射逻辑。这种设计允许数据像管道一样流动,无需等待整个响应结束。
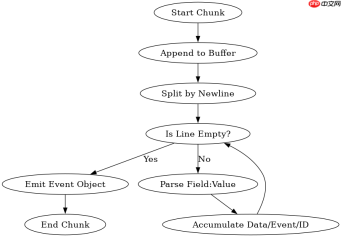
class SSEParserTransform extends TransformStream {
  constructor() {
    let buffer = '';
    super({
      transform(chunk, controller) {
        buffer += chunk;
        const lines = buffer.split('\n');
        // 保留最后一个可能不完整的片段
        buffer = lines.pop();

        for (const line of lines) {
          if (line.startsWith(':')) continue; // 忽略注释
          if (line === '') {
            // 空行表示当前事件结束,由外部逻辑处理累积的数据
            // 这里我们假设外部逻辑会收集 data/event/id
            // 为了简化演示,我们在 parser 内部直接输出结构化对象
            // 实际生产中通常在这里 emit 一个 event object
            if (currentEvent.data) {
              controller.enqueue(currentEvent);
              currentEvent = { data: '', event: 'message', id: null };
            }
            continue;
          }

          const colonIndex = line.indexOf(':');
          const field = line.substring(0, colonIndex);
          const value = line.substring(colonIndex + 1).trimStart();

          if (field === 'data') {
            currentEvent.data += value + '\n';
          } else if (field === 'event') {
            currentEvent.event = value;
          } else if (field === 'id') {
            currentEvent.id = value;
          }
        }
      },
      flush(controller) {
        if (buffer && currentEvent.data) {
           // 处理尾部残留
           controller.enqueue(currentEvent);
        }
      }
    });
    this.currentEvent = { data: '', event: 'message', id: null };
  }
}

// 使用示例
async function fetchSSE(url) {
  const response = await fetch(url);
  const reader = response.body.getReader();
  const decoder = new TextDecoder();
  const parser = new SSEParserTransform();

  // 连接流:reader -> text decoder -> sse parser -> consumer
  const readableStream = reader.read().then(function process({ done, value }) {
    if (done) return;
    const text = decoder.decode(value, { stream: true });
    // 注意:实际使用中需要将 parser 接入 pipeThrough
    // 这里仅展示逻辑结构
    return reader.read().then(process);
  });
}
上述代码展示了 SSEParserTransform 的基本骨架。在实际调用中,你会将 fetch 返回的 body 通过 pipeThrough(new SSEParserTransform()) 进行处理,从而得到一个只包含完整事件对象的流。每个事件对象都包含 data(字符串)、event(默认是 message)和 id(可选)。
如何在消费者端消费解析后的事件流
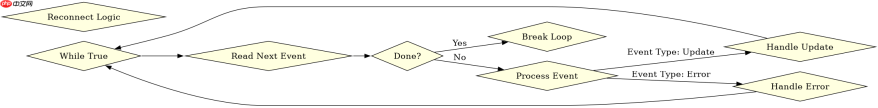
一旦获得了经过 SSEParserTransform 处理后的可读流,就可以使用 for await...of 语法异步迭代每一个完整的事件。这种方式天然支持背压控制,当消费者处理较慢时,上游会自动暂停读取,防止内存溢出。同时,可以在循环内部根据 event.type 进行分支处理,实现不同业务逻辑的解耦。

使用Atmosphere构建通过WebSocket、SSE、gRPC、WebTransport、MCP、A2A和AG-UI流传输的JVM代理网关,并带有治理钩子。
async function consumeEvents(url) {
  try {
    const response = await fetch(url);
    if (!response.ok) throw new Error(`HTTP ${response.status}`);

    const reader = response.body.getReader();
    const decoder = new TextDecoder();
    const parser = new SSEParserTransform();

    // 构建管道
    const stream = reader.read().pipeTo(
      new WritableStream({
        write(chunk) {
          const text = decoder.decode(chunk, { stream: true });
          // 这里需要更复杂的 pipe 组合,简化版如下:
          // 实际上推荐直接使用 pipeThrough
        }
      })
    );

    // 更标准的写法:
    const sseStream = response.body
      .pipeThrough(new TextDecoderStream())
      .pipeThrough(new SSEParserTransform());

    const readerForEvents = sseStream.getReader();

    while (true) {
      const { done, value } = await readerForEvents.read();
      if (done) break;

      console.log(`Event: ${value.event}, ID: ${value.id}`);
      console.log(`Data: ${value.data}`);

      // 根据 event 类型分发处理
      if (value.event === 'update') {
        handleUpdate(JSON.parse(value.data));
      } else if (value.event === 'error') {
        handleError(value.data);
      }
    }
  } catch (err) {
    console.error('Connection lost:', err);
  }
}
在消费者端,重点在于异常处理和连接恢复。如果 read() 抛出错误,通常意味着连接断开。此时可以结合指数退避算法重新调用 fetchSSE 函数,实现自动重连。对于 id 字段,如果服务端提供了 Last-Event-ID 机制,客户端应在重连时将最后收到的 id 放入请求头,以确保数据连续性。
如何处理多行数据字段中的换行符
当 SSE 消息的 data 字段包含多行内容时,标准规定每行都以 data: 开头,且后续行以空格或制表符缩进。解析器必须将这些带有前缀的行合并到同一个事件的 data 属性中,并在遇到空行时才认为该事件结束。如果不正确处理,多行 JSON 数据会被截断或解析失败。
在之前的 SSEParserTransform 实现中,我们通过 currentEvent.data += value + '\n' 累加了所有 data 字段的内容。这意味着即使数据跨越多行,它们也会被拼接成一个完整的字符串。例如,如果服务端发送:
data: {"key": "val"
data: ue"}
解析器会将这两行合并为 {"key": "value"}\n(注意末尾的换行符可能需要修剪)。消费者在接收到这个事件后,可以直接使用 JSON.parse(value.data.trim()) 安全地解析出原始对象。这种处理方式兼容了大多数遵循 RFC 的标准 SSE 实现,确保了复杂数据结构传输的可靠性。
大量免费API接口:立即使用
涵盖生活服务API、金融科技API、企业工商API、等相关的API接口服务。免费API接口可安全、合规地连接上下游,为数据API应用能力赋能!





