






在sql中,使用 union all 合并两个 select 结果集的高效做法是:确保两个查询的列数、数据类型和顺序完全一致,并避免在合并后的结果上直接进行无索引的排序或去重操作。与 union 不同,union all 不会执行隐式的去重步骤,因此性能更高,适用于数据源本身已区分或允许重复的场景。
如何验证UNION ALL对列类型不一致的处理行为?
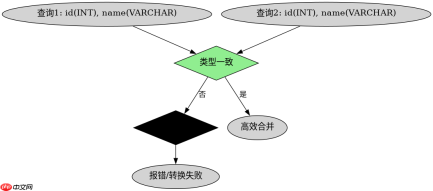
当两个 SELECT 语句的列类型不匹配时,数据库会尝试进行隐式类型转换,若转换失败则抛出错误。例如,将整数列与字符串列合并时,多数数据库(如 MySQL、PostgreSQL)会报错,而 SQL Server 可能根据优先级进行转换。为确保高效且安全,应在应用层或查询层显式处理类型一致性。
SELECT id, name FROM users WHERE status = 'active'
UNION ALL
SELECT id, name FROM archived_users WHERE status = 'inactive';
上述代码中,两个子查询均返回两列:id 和 name,类型均为 INT 和 VARCHAR,结构一致,可高效合并。若第二个查询改为 SELECT id, CAST(name AS INT) ...,则可能因数据内容非数字而失败。
UNION ALL 与 UNION 在去重开销上的差异是什么?
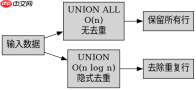
UNION 会在合并后执行去重操作,通常通过排序或哈希实现,时间复杂度为 O(n log n) 或 O(n),而 UNION ALL 仅做简单拼接,时间复杂度为 O(n)。因此,当数据量较大且允许重复时,UNION ALL 显著更快。
-- 低效:隐式去重
SELECT id FROM table_a
UNION
SELECT id FROM table_b;

-- 高效:无去重
SELECT id FROM table_a
UNION ALL
SELECT id FROM table_b;
若业务逻辑允许重复 ID,应优先使用 UNION ALL。若需去重,建议在合并后使用 DISTINCT 或窗口函数按需处理,而非依赖 UNION 的全局去重。
当输入包含空值时,UNION ALL 如何处理 NULL 字段?
UNION ALL 对 NULL 值的处理遵循 SQL 标准:NULL 被视为有效值,不参与去重判断(即使使用 UNION,两个 NULL 也不会被合并)。例如,若两个子查询均返回 (1, NULL),UNION ALL 会保留两条记录,而 UNION 也会保留两条,因为 NULL = NULL 结果为 UNKNOWN,不满足相等条件。
SELECT 1 AS id, NULL AS value
UNION ALL
SELECT 1 AS id, NULL AS value;
输出结果为两行:(1, NULL) 和 (1, NULL)。若需将 NULL 视为相同值进行去重,需使用 COALESCE(value, 'DEFAULT') 等函数预处理。


