






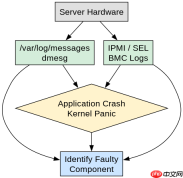
排查服务器硬件故障的核心做法是结合操作系统日志(如 /var/log/messages 或 dmesg)与带外管理接口日志(如 ipmi/bmc),通过定位具体的错误代码(如 cecc、ecc)和物理位置(如 dimm slot)来锁定故障部件。
如何识别内存相关的硬件报错
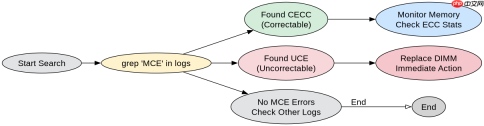
在 Linux 系统中,内存硬件故障通常表现为 Machine Check Exception (MCE)。这类错误会被内核记录在 /var/log/mcelog 或 /var/log/syslog 中。要识别此类问题,需要搜索包含 MCE、machine check 或 CECC(Correctable Error Corrected ECC)关键字的日志行。这些条目会明确指出发生错误的 CPU 核心、Bank 以及对应的物理内存地址。
#!/bin/bash
# 检查 MCE 日志中的内存错误
LOG_FILE="/var/log/mcelog" # 假设 mcelog 已安装并运行
if [ -f "$LOG_FILE" ]; then
    grep -i "cecc\|correctable" "$LOG_FILE" | tail -n 5
else
    echo "mcelog not found or no data."
fi
上述脚本用于提取最近的内存纠错记录。如果输出中包含具体的 Bank 编号(如 Bank 0)和物理地址,说明该内存条存在轻微错误但被纠正;若出现 Uncorrectable 字样,则意味着发生了不可恢复的硬件故障,系统可能已经崩溃或即将崩溃。
如何通过 BMC 日志定位物理组件
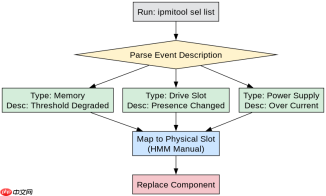
当操作系统层面的日志信息不足时,服务器基板管理控制器(BMC)提供的 IPMI SEL(System Event Log)是更底层的证据来源。BMC 独立于主机操作系统运行,能够记录电源、风扇、电压及硬盘等组件的状态变化。使用 ipmitool sel list 命令可以获取这些事件。重点关注类型为 Threshold 或 Hardware Interrupt 的事件,它们通常直接指向具体的物理插槽或设备 ID。
#!/bin/bash
# 使用 ipmitool 获取最近 10 条 SEL 日志
ipmitool sel list | tail -n 10
执行该命令后,观察输出中的 Description 列。例如,若看到 Memory Threshold Degraded,则表明内存子系统出现了非致命但需关注的状态变化。结合 Event Type 中的传感器类型(如 Memory 或 Drive Slot),可以快速判断是内存条还是硬盘背板的问题。此方法不依赖操作系统的稳定性,即使在系统死机后也能通过重启后的日志回溯故障瞬间。
根据日志中的物理地址映射到具体插槽
在确认了内存错误后,下一步是将日志中的逻辑地址或 Bank 号映射到主板上的物理插槽(如 DIMM_A1)。这通常需要查阅服务器的硬件维护手册(HMM)。不同厂商(如 Dell、HP、Lenovo)的 Bank 编号规则不同。例如,Dell iDRAC 日志中常直接提供 Slot 信息,而通用 Linux 内核日志可能需要通过 dmidecode -t memory 查看当前配置,再结合 mcelog 输出的 Address 进行计算或查表。





