






为什么在SQL中使用GROUP BY分组后总行数计算变慢
使用group by后查询变慢,核心原因是数据库无法直接复用索引中的计数信息,必须执行全表扫描或索引扫描来逐行聚合数据。当没有合适的覆盖索引时,优化器需要读取大量数据页,进行哈希或排序操作,并统计每个分组的行数,这比直接查询count(*)或简单范围查询要昂贵得多。

如何验证当前查询的执行计划与瓶颈
通过EXPLAIN分析SQL语句,可以确认是否发生了全表扫描(type=ALL)以及是否使用了临时表(Using temporary)和文件排序(Using filesort)。如果看到这些标志,说明数据库正在内存或磁盘上构建临时结构来处理分组,这是性能下降的直接证据。
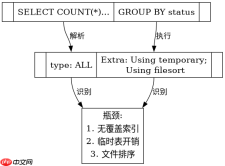
SELECT COUNT(*), status FROM orders GROUP BY status;
预期结果:EXPLAIN显示type为ALL,Extra包含Using temporary; Using filesort。若status列有索引,type可能为index,但仍需扫描整个索引树。
基于orders表中status字段的具体问题分析
针对orders表的status字段,如果该字段区分度低(如只有'pending', 'completed'等少数几个值),GROUP BY产生的分组很少,但每组的行数很多。此时,即使有索引,MySQL也可能选择全索引扫描而非回表,因为随机IO成本高于顺序IO。此外,如果查询涉及WHERE子句过滤,且过滤条件不在GROUP BY列上,会导致先过滤再分组,进一步增加处理量。

-- 假设orders表结构
CREATE TABLE orders (
    id INT PRIMARY KEY,
    user_id INT,
    status VARCHAR(20),
    created_at DATETIME
);

-- 插入测试数据
INSERT INTO orders (user_id, status, created_at) VALUES
(1, 'pending', '2023-01-01'),
(2, 'completed', '2023-01-02'),
(1, 'completed', '2023-01-03'),
(3, 'pending', '2023-01-04');

-- 执行分组查询
SELECT status, COUNT(*) as cnt FROM orders GROUP BY status;
预期结果:返回两行,status='pending'对应cnt=2,status='completed'对应cnt=2。若数据量大,此操作耗时显著增加。


