






使用 system.text.regularexpressions.regex 配合 regexoptions.ecmascript 模式,将字符串转换为十六进制转义序列,即可直观检查不可见字符。具体做法是调用 regex.replace(input, "[^"]", m => $"\x{(int)m.value[0]:x4}"),该操作会将所有非打印字符替换为 xhhhh 格式,从而暴露隐藏的控制符或零宽字符。

如何识别常见的控制字符和零宽字符?
通过正则表达式匹配特定的 Unicode 范围,可以精准定位如制表符、换行符以及零宽空格等常见不可见字符。针对这些特定字符,可以使用 char.IsControl() 进行初步筛选,或者在正则中直接列出目标字符的十六进制代码点,以便在日志或调试窗口中快速发现异常。
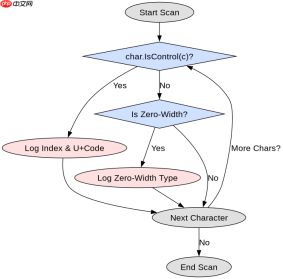
using System;
using System.Text.RegularExpressions;

class Program
{
    static void Main()
    {
        string input = "Hellou200BWorld	!"; // 包含零宽空格和制表符

        // 方法1:全量转义
        string escaped = Regex.Replace(input, @"[^ -~]", m => $"\x{(int)m.Value[0]:X4}");
        Console.WriteLine($"Full Escape: {escaped}");

        // 方法2:仅检测控制字符
        bool hasControl = false;
        foreach (char c in input)
        {
            if (char.IsControl(c))
            {
                hasControl = true;
                Console.WriteLine($"Found control char at index {input.IndexOf(c)}: U+{(int)c:X4}");
            }
        }
        Console.WriteLine($"Has Control: {hasControl}");
    }
}
如何处理从外部源读取的带有 BOM 的字符串?
当字符串源自文件读取或网络传输时,常伴随字节顺序标记(BOM)。使用 Encoding.UTF8.GetString(bytes, startIndex, length) 并手动跳过前三个字节,或在解析后使用 TrimStart('uFEFF') 去除首部的 BOM 字符,可确保内容纯净。若需验证是否残留 BOM,可检查字符串第一个字符的 Unicode 值是否为 65279。


using System;
using System.IO;
using System.Text;

class Program
{
    static void Main()
    {
        // 模拟带有 UTF-8 BOM 的字节数组
        byte[] bytesWithBom = new byte[] { 0xEF, 0xBB, 0xBF, 0x48, 0x65, 0x6C, 0x6C, 0x6F }; // "Hello"

        // 方式1:直接解码并移除 BOM
        string text = Encoding.UTF8.GetString(bytesWithBom);
        if (text.StartsWith("uFEFF"))
        {
            text = text.Substring(1);
        }
        Console.WriteLine($"Clean Text: '{text}'");
        Console.WriteLine($"First Char Code: {(int)text[0]}");
    }
}
基于程序中某个输入、条件或结果的具体问题
当输入字符串包含混合的不可见字符时,正则替换与逐个字符检查的结果会因实现逻辑不同而产生差异。例如,Regex.Replace 会一次性输出所有非 ASCII printable 字符的转义形式,而 char.IsControl 循环仅报告控制类字符,可能遗漏零宽空格等非控制但不可见的字符。在实际排查中,应优先使用全量转义方案以获取完整视图,避免漏判。









