Substring遇到空输入会返回什么
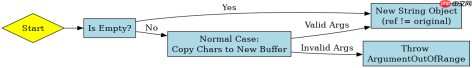
substring在起始索引为0且长度为字符串总长时,不会抛出异常,而是直接返回原字符串的副本。这意味着对于空字符串或完全匹配的情况,它表现得非常安全,但始终涉及内存分配和字符复制操作。
using System;

class Program
{
    static void Main()
    {
        string text = "";
        // 情况1:空字符串调用 Substring(0, 0)
        try
        {
            string result1 = text.Substring(0, 0);
            Console.WriteLine($"Result: '{result1}' | Length: {result1.Length}");
        }
        catch (Exception ex)
        {
            Console.WriteLine($"Error: {ex.GetType().Name}");
        }

        // 情况2:正常字符串调用 Substring(0, length)
        string normal = "Hello";
        string result2 = normal.Substring(0, normal.Length);
        Console.WriteLine($"Result: '{result2}' | IsSameRef: {ReferenceEquals(normal, result2)}");
    }
}
运行上述代码,第一段输出为 Result: '' | Length: 0,第二段输出为 Result: 'Hello' | IsSameRef: False。这证实了 Substring 即使在不截取任何内容时,也会创建一个新的字符串对象,而不是引用原对象。
[..]切片表达式在边界检查上的行为差异
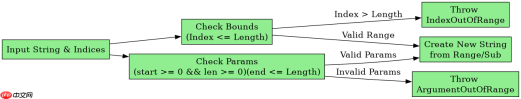
C# 8.0 引入的范围运算符 [..] 在处理越界索引时会立即抛出 IndexOutOfRangeException,而 Substring 则会在参数不合法时抛出 ArgumentOutOfRangeException。两者的核心区别在于对“范围”语义的处理:[..] 严格遵循数组/字符串的索引边界,不允许超出物理长度。

using System;

class Program
{
    static void Main()
    {
        string text = "ABC";

        // 情况1:使用切片表达式 [..] 尝试获取超出长度的部分
        try
        {
            // 假设我们错误地认为可以取到索引3(实际最大是2)
            // 这里演示一个合法的切片和一个非法的切片对比
            var slice1 = text[..2]; // 合法
            Console.WriteLine($"Slice [..2]: '{slice1}'");

            // 非法切片:索引超出范围
            // var slice2 = text[..4]; // 这会抛出 IndexOutOfRangeException
        }
        catch (Exception ex)
        {
            Console.WriteLine($"Slice Error: {ex.GetType().Name} - {ex.Message}");
        }

        // 情况2:使用 Substring 尝试获取超出长度的部分
        try
        {
            // Substring 允许 end index 等于 Length
            var sub1 = text.Substring(0, 3);
            Console.WriteLine($"Substr(0,3): '{sub1}'");

            // 非法 Substring:end index > Length
            var sub2 = text.Substring(0, 4); // 这会抛出 ArgumentOutOfRangeException
        }
        catch (Exception ex)
        {
            Console.WriteLine($"Substr Error: {ex.GetType().Name} - {ex.Message}");
        }
    }
}
执行结果中,切片表达式若越界会报 IndexOutOfRangeException,而 Substring 越界报 ArgumentOutOfRangeException。这表明 [..]更贴近底层内存布局的检查机制,而 Substring 更侧重于方法参数的逻辑合法性。
基于程序中某个输入、条件或结果的具体问题
当处理包含 Unicode 代理对(Surrogate Pairs)的字符串时,Substring 和 [..] 都会按 UTF-16 code unit(即 char)进行切割,而不是按视觉字符(Grapheme Cluster)切割。如果输入的字符串中包含像 emoji 这样的双字节字符,两者都可能产生截断的无效字符序列,导致显示乱码或后续处理错误。
using System;

class Program
{
    static void Main()
    {
        // "?" 是一个代理对,由两个 char 组成
        string text = "A?B";
        Console.WriteLine($"Length: {text.Length}"); // 输出 4 (A, High, Low, B)

        // 错误地只取前2个 char,会截断 emoji
        string badSlice = text[..2];
        Console.WriteLine($"Bad Slice: '{badSlice}'"); // 输出 "A?" 或乱码

        // Substring 同样行为
        string badSub = text.Substring(0, 2);
        Console.WriteLine($"Bad Sub: '{badSub}'"); // 输出 "A?" 或乱码
    }
}
这段代码展示了两者在底层实现上的一致性:它们都基于 char 计数。在实际开发中,如果需要按视觉字符切割,应使用 StringInfo 类或 System.Text.RegularExpressions,而不是直接使用这两种语法糖。它们的区别仅在于语法简洁度和异常类型的细微差别,但在处理多字节字符时的风险是相同的。