






在 docker swarm 中,将更新失败后的策略设置为 continue,需要在执行 docker service update 命令时添加 --update-failure-action=continue 参数。该设置会指示 swarm 管理器在滚动更新过程中,如果某个节点上的任务更新失败(例如容器启动失败或健康检查未通过),则跳过该节点并继续更新其他节点,而不是暂停整个更新进程。默认情况下,swarm 的失败处理行为是 pause,即遇到第一个失败就停止后续更新。
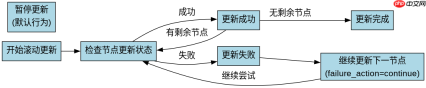
docker service update 命令中如何指定失败动作
要修改现有服务的更新策略,直接使用 docker service update 命令并传入 --update-failure-action=continue 即可。此操作会立即更新服务配置,影响后续的滚动更新行为。需要注意的是,这个参数只控制“更新过程中”的行为,不影响服务创建时的初始部署逻辑,也不影响手动重启服务时的行为。
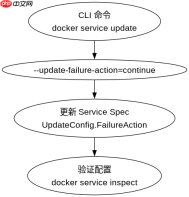
docker service update
  --update-failure-action continue
  my_service
上述命令将名为 my_service 的服务配置为在更新失败时继续执行。执行后,可以通过 docker service inspect --format '{{.Spec.UpdateConfig.FailureAction}}' my_service 来验证配置是否生效,预期输出应为 continue。
使用 docker stack deploy 时如何配置失败策略
在使用 Compose 文件并通过 docker stack deploy 部署服务时,需要在 deploy.update_config 部分明确指定 failure_action 字段。这是生产环境中更常见的配置方式,因为它允许将更新策略作为代码的一部分进行版本控制和管理。


version: '3.8'
services:
  web:
    image: nginx:latest
    deploy:
      update_config:
        parallelism: 1
        delay: 10s
        failure_action: continue
        monitor: 5s
        order: start-first
在上述 Compose 文件中,failure_action: continue 确保了当 web 服务进行滚动更新时,如果新版本的容器无法启动,Swarm 会继续尝试更新下一个副本,而不会中断整个部署流程。这与命令行方式的原理相同,只是配置位置不同。
当 failure_action 设为 Continue 时,具体会发生什么
当 failure_action 被设置为 continue 时,Swarm 管理器的行为是:一旦检测到某个任务实例更新失败(例如进入 FAILED 状态),它会记录该失败,但不会暂停对其他副本的更新。更新过程会按照 parallelism 设置的并发数继续进行。最终,那些更新失败的副本会保持在旧版本状态(如果回滚未触发)或根据 rollback_config 进行处理,但关键点是整个更新作业不会因此停滞。这适用于那些可以容忍部分节点暂时不可用或需要人工介入修复的场景。


