






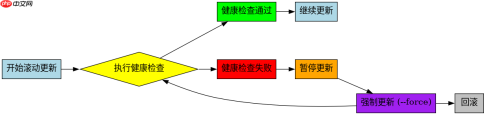
在 docker swarm 中,如果滚动更新因健康检查失败被自动暂停或回滚,可以通过设置 --update-parallelism 为 0 配合 --update-delay 来手动控制节奏,或者更直接地,使用 docker service update --force 强制重新部署当前服务以跳过当前的挂起状态。若需彻底忽略健康检查导致的失败并继续滚动,可以在更新命令中加入 --update-no-health-check 参数(如果版本支持)或在服务定义中调整健康检查逻辑。通常,最稳妥的强制跳过方式是先停止当前的更新进程,然后重新发起更新并调整策略。
如何查看当前卡住的更新任务状态
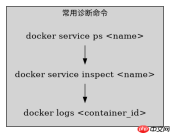
当滚动更新遇到健康检查失败时,Swarm 会暂停后续节点的更新。要确认当前状态,可以使用 docker service ps 命令查看具体哪个节点的任务处于 Failed 或 RolledBack 状态。这有助于判断是镜像问题还是配置问题导致的健康检查超时。
docker service ps <service_name> --no-trunc
# 输出示例:
ID                  NAME                IMAGE               NODE                DESIRED STATE       CURRENT STATE           ERROR               PORTS
abc123              myapp.1             myimage:latest      node1               Running             Running 5 minutes ago
def456              myapp.2             myimage:new         node2               Failed              Failed 2 minutes ago    "health check failed"   </service_name>
通过上述命令,可以明确看到哪些节点因为健康检查失败而停滞。如果所有新任务都显示 Failed,说明镜像或配置有严重问题;如果只是部分失败,可能是网络或资源竞争导致。
如何强制跳过健康检查失败并继续更新
要强制跳过健康检查失败,最直接的方法是使用 docker service update 命令并指定 --force 标志。这会强制 Swarm 重新调度所有任务,忽略之前的更新状态。如果希望完全禁用健康检查对更新流程的影响,可以在更新时添加 --update-no-health-check 参数(注意:此参数在某些旧版本中可能不可用,建议升级 Docker 或使用 --rollback 后重新配置健康检查)。

Docker Hub (hub.docker.com)。此技能适用于所有 Docker Hub 操作,包括读取、创建、更新和删除数据。只要任务涉及 Docker Hub,就使用此技能。
# 方法一:强制重新部署,忽略当前失败状态
docker service update --force <service_name>

# 方法二:如果支持,禁用健康检查检查(Docker 18.09+)
docker service update --update-no-health-check <service_name>

# 方法三:调整更新策略,允许更多并行失败
docker service update --update-parallelism 2 --update-delay 10s <service_name></service_name></service_name></service_name>
执行 --force 后,Swarm 会尝试重新启动所有容器。如果健康检查依然失败,服务可能会再次进入失败状态。此时需要检查应用日志或健康检查脚本,确保应用能正确响应健康检查请求。如果确定要忽略健康检查,可以临时修改服务的健康检查配置,例如增加 --health-interval 或 --health-retries,给应用更多启动时间。
基于服务配置中HealthCheck参数的具体影响
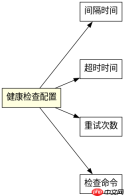
在 Docker Swarm 中,服务的健康检查参数(如 --health-cmd, --health-interval, --health-timeout, --health-retries)直接影响滚动更新的成败。如果健康检查命令过于严格或超时时间过短,会导致更新过程中大量任务失败。例如,设置 --health-retries 3 意味着连续 3 次检查失败才会标记为 unhealthy,这比默认的 1 次重试更宽容。调整这些参数可以避免因短暂的网络波动或应用启动慢而导致的误判。


