






在 docker swarm 中实现服务无缝零中断滚动更新,核心在于配置 update_config 参数。通过设置 parallelism 控制每次更新的副本数,利用 delay 指定批次间的等待时间,并配合健康检查 healthcheck 确保新实例完全就绪后再替换旧实例,从而保证服务始终可用。
如何配置滚动更新的具体参数与顺序
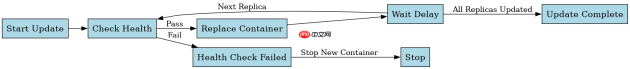
要实现平滑更新,必须显式定义 update_config 中的关键属性。默认情况下,Swarm 会同时停止所有旧容器并启动新容器,这会导致服务中断。通过设置 parallelism: 1,可以强制 Swarm 一次只更新一个副本;设置 delay: 10s 可以在每个副本更新完成后等待 10 秒,确保新服务稳定运行后再进行下一个。此外,order: start-first 确保新容器先启动,待其通过健康检查后,再停止旧容器,这是实现零中断的关键逻辑。
version: '3.8'
services:
  web:
    image: nginx:latest
    deploy:
      replicas: 3
      update_config:
        parallelism: 1
        delay: 10s
        order: start-first
      rollback_config:
        parallelism: 1
        delay: 5s
        order: stop-first
      restart_policy:
        condition: on-failure
        max_attempts: 3
    ports:
      - "80:80"
    healthcheck:
      test: ["CMD", "curl", "-f", "http://localhost"]
      interval: 10s
      timeout: 5s
      retries: 3
上述配置定义了三个副本的 Nginx 服务。当执行 docker service update --force 时,Swarm 调度器会选取一个任务,启动新的 Nginx 容器。新容器启动后,健康检查开始运行。只有当健康检查连续三次成功(或达到阈值),该新任务状态变为 Running 且被标记为“就绪”后,Swarm 才会停止对应的旧容器。随后,它等待 10 秒,再对下一个副本执行相同操作。这种串行且带延迟的更新方式,确保了在任何时刻都有至少两个健康的副本在处理流量。
回滚机制如何在更新失败时保障服务连续性
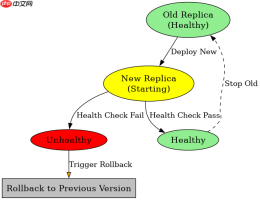
滚动更新过程中若新镜像存在缺陷,Swarm 支持自动或手动回滚到之前的版本。这需要配置 rollback_config。与更新类似,回滚也遵循 parallelism 和 delay 的设置。关键区别在于 order:回滚时通常使用 stop-first,即先停止故障的新容器,再启动旧版本的容器,以避免新旧版本混合导致的潜在兼容性问题或资源冲突。如果更新过程中健康检查失败次数超过限制,Swarm 会自动触发回滚流程,将服务恢复到上一个已知良好的状态。

Docker Hub (hub.docker.com)。此技能适用于所有 Docker Hub 操作,包括读取、创建、更新和删除数据。只要任务涉及 Docker Hub,就使用此技能。

# 手动触发回滚到上一个版本
docker service rollback <service_name>

# 查看服务更新历史
docker service inspect --format '{{json .UpdateStatus}}' <service_name></service_name></service_name>
在实际操作中,开发者可以通过 docker service rollback 命令手动触发回滚。Swarm 会根据之前保存的服务配置快照,按照 rollback_config 中定义的策略逐步替换当前运行的容器。例如,如果更新配置是每次 1 个副本、延迟 10 秒,回滚也会以相同的节奏进行,但方向相反。这种机制为生产环境的发布提供了安全网,确保即使新版本出现严重 bug,也能快速恢复服务可用性,而无需人工干预复杂的容器编排逻辑。
健康检查未通过时滚动更新的行为表现
当新启动的容器未能通过 healthcheck 定义的检查时,滚动更新会暂停并进入错误状态。Swarm 不会继续更新剩余的副本,而是保持当前已更新部分的状态不变,等待管理员介入。此时,docker service ps 会显示相关任务的状态为 Failed 或 Restarting。系统不会自动回滚,除非配置了自动回滚策略或管理员手动执行回滚命令。这种行为防止了有缺陷的代码扩散到整个服务集群,但也要求运维人员具备快速响应和处理容器日志的能力。


