






java 数据库连接池配置主从切换的核心在于使用支持读写分离的代理层,而非直接修改基础连接池参数。通常的做法是引入 shardingsphere-jdbc 或 mybatis-plus 等中间件,通过配置文件指定数据源路由规则,让框架根据 sql 类型自动将写操作指向主库、读操作指向从库。
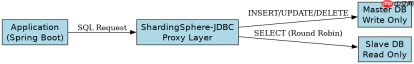
ShardingSphere-JDBC 如何配置多数据源路由
在 Spring Boot 项目中集成 ShardingSphere-JDBC 是实现主从切换最标准的方式。你需要定义主库和从库的连接信息,并配置 `master-slave-rules` 来指定哪些表走哪个路由策略。框架会自动拦截 SQL,如果是 INSERT/UPDATE/DELETE 则强制走主库,SELECT 则轮询从库。
spring:
  shardingsphere:
    datasource:
      names: ds-master,ds-slave
      ds-master:
        type: com.zaxxer.hikari.HikariDataSource
        driver-class-name: com.mysql.cj.jdbc.Driver
        jdbc-url: jdbc:mysql://localhost:3306/master_db
        username: root
        password: master_pass
      ds-slave:
        type: com.zaxxer.hikari.HikariDataSource
        driver-class-name: com.mysql.cj.jdbc.Driver
        jdbc-url: jdbc:mysql://localhost:3306/slave_db
        username: root
        password: slave_pass
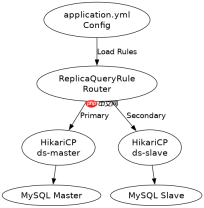
    rules:
      replica-query:
        data-sources:
          ds:
            primary-data-source-name: ds-master
            slave-data-source-names: ds-slave
            load-balancer-type: ROUND_ROBIN
    props:
      sql-show: true
运行上述配置后,执行 SELECT 语句会打印出指向 `ds-slave` 的日志,而 INSERT 语句会指向 `ds-master`。这实现了透明的读写分离,应用代码无需感知底层数据源的变化。
HikariCP 结合动态数据源如何实现切换
如果不希望引入重型框架,可以使用 HikariCP 配合自定义的动态数据源路由。核心思路是创建一个继承自 `AbstractRoutingDataSource` 的类,重写 `determineCurrentLookupKey()` 方法。该方法返回一个 Key,Spring 会根据这个 Key 从 Map 中获取对应的 HikariDataSource 实例。通过 ThreadLocal 存储当前请求的类型(READ 或 WRITE),即可实现基于线程上下文的切换。


public class DynamicDataSource extends AbstractRoutingDataSource {
    @Override
    protected Object determineCurrentLookupKey() {
        return DataSourceContextHolder.getDbType();
    }
}

// 使用示例
DataSourceContextHolder.setDbType(DataSourceType.MASTER);
// 执行写操作
DataSourceContextHolder.setDbType(DataSourceType.SLAVE);
// 执行读操作
这种方案需要手动管理上下文,适合对性能敏感且逻辑简单的场景。HikariCP 本身只负责单个连接池的高效管理,不负责路由,因此必须依赖外部的路由逻辑来决定具体连接哪个 URL。
主从切换时事务一致性如何保证
在主从切换配置中,最大的风险是“读已提交”不一致问题。当应用写入主库后,立即在同一事务或紧接的请求中读取数据,可能因为主从同步延迟而从库读到旧数据。ShardingSphere-JDBC 提供了 `read-from-preferred-data-source-name` 配置,允许在特定条件下强制读主库。此外,对于强一致性要求的业务,应使用 `@Transactional` 注解包裹读写混合的操作,确保整个事务期间所有查询都路由到主库,避免跨库读取导致的数据脏读。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


