






java 数据库连接池配置故障转移的核心在于启用高可用(ha)模式并正确设置多数据源地址。以主流的 hikaricp 为例,你需要将 jdbc url 指向 haproxy、proxysql 或 mysql group replication 等中间件,而不是直连单点数据库。这样当主库宕机时,中间件会自动将连接重定向到备用节点,应用层无需修改代码即可实现无缝切换。
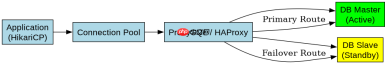
如何配置支持故障转移的 JDBC URL
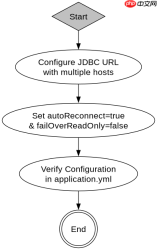
在 Spring Boot 或标准 Java 应用中,只需修改 application.yml 中的 spring.datasource.url 属性。关键在于 URL 必须包含多个主机地址,且通常需要使用特定的协议前缀来标识这是集群地址。例如,使用 ProxySQL 时,URL 格式为 jdbc:mysql://proxy_host:port/db_name;若使用原生 MySQL Connector/J 的自动故障转移功能,则需添加 &autoReconnect=true&failOverReadOnly=false 参数,并列出所有候选节点。
spring:
  datasource:
    url: jdbc:mysql://192.168.1.10:3306,192.168.1.11:3306/mydb?autoReconnect=true&failOverReadOnly=false
    username: root
    password: secret
    driver-class-name: com.mysql.cj.jdbc.Driver
    hikari:
      maximum-pool-size: 10
      connection-timeout: 30000
上述配置中,url 字段列出了两个 IP 地址。MySQL 驱动会尝试按顺序连接第一个地址,如果失败,则自动切换到第二个。配合 HikariCP 的连接超时设置,可以在网络抖动或节点宕机时快速失败并重试。注意,failOverReadOnly=false 确保故障转移后连接仍具备读写权限,避免业务逻辑因只读状态报错。
如何验证故障转移后的连接状态
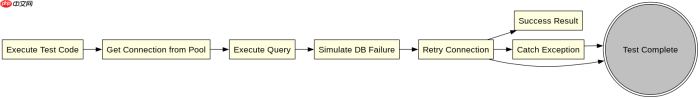
配置完成后,需要验证应用是否能正确处理断连并重新获取有效连接。可以通过模拟主库宕机或使用 kill -9 终止数据库进程来测试。HikariCP 会在检测到连接失效时,自动从池中移除该连接并创建新连接。此时,应用日志中应出现 HikariPool-1 - Connection is not available, request timed out after 30000ms 类似的警告,随后成功建立新连接。

// 模拟测试代码
@Autowired
private DataSource dataSource;

public void testFailover() {
    try (Connection conn = dataSource.getConnection()) {
        System.out.println("Connected to: " + conn.getMetaData().getURL());
        // 执行查询
        try (Statement stmt = conn.createStatement();
             ResultSet rs = stmt.executeQuery("SELECT 1")) {
            while (rs.next()) {
                System.out.println("Query result: " + rs.getInt(1));
            }
        }
    } catch (SQLException e) {
        e.printStackTrace();
    }
}
运行此代码并在执行期间切断主库连接,观察控制台输出。如果配置正确,应用应在短暂等待后打印出新的连接 URL 和查询结果,证明故障转移生效。务必确保测试环境中的备用节点已同步最新数据,否则可能出现数据不一致问题。
故障转移期间事务如何处理
当故障转移发生时,正在进行的事务会被中断。HikariCP 本身不管理事务生命周期,事务的回滚或提交由数据库驱动和应用框架决定。在自动故障转移场景下,未提交的事务通常会回滚,因为底层 TCP 连接断开。应用层需要捕获 SQLException 并根据业务需求决定是重试还是抛出异常。对于关键业务,建议在应用层实现重试机制,如使用 Spring Retry 或手动循环重试,以应对短暂的连接不可用状态。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


