






优化 java arraylist 批量操作性能的核心在于减少动态扩容带来的数组拷贝开销,并在遍历或修改时避免并发修改异常。最直接的做法是在初始化时通过构造函数指定预估容量,从而消除 resize 过程中的内存分配与 system.arraycopy 调用;若涉及大量添加,可预先计算所需大小并一次性扩容。对于读取密集型场景,使用增强 for 循环(迭代器)或传统索引循环比 stream api 更高效,因为后者会引入对象创建和中间状态管理的额外开销。

ArrayList 初始化时的容量预分配策略
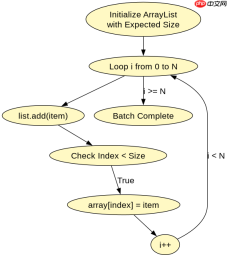
在构建 ArrayList 时直接传入预估的初始容量,可以彻底避免默认容量下的多次扩容。Java 的 ArrayList 底层基于数组实现,当元素数量超过当前容量时,会自动创建一个新数组并将旧数据拷贝过去,这个过程在批量插入大量数据时非常耗时。通过 new ArrayList(expectedSize) 指定大小,JVM 只需分配一次内存空间,后续 add 操作仅涉及简单的赋值,无需触发 grow() 方法中的扩容逻辑。
import java.util.ArrayList;
import java.util.List;

public class CapacityOptimization {
    public static void main(String[] args) {
        // 假设已知需要存储 10000 个元素
        int expectedSize = 10000;

        // 错误做法:使用无参构造函数,默认容量为 10,会频繁扩容
        List<string> badList = new ArrayList();
        long startBad = System.nanoTime();
        for (int i = 0; i  goodList = new ArrayList(expectedSize);
        long startGood = System.nanoTime();
        for (int i = 0; i <p>运行上述代码,<code>badList</code> 会因为默认的 10、15、22... 等扩容序列产生多次数组拷贝,而 <code>goodList</code> 仅分配一次内存。预期结果是 <code>Pre-sized capacity time</code> 显著小于 <code>Default capacity time</code>,尤其是在数据量较大时差异明显。注意,如果预估容量远大于实际使用量,虽然避免了扩容,但会浪费堆内存,因此预估应尽量准确。</p>
<h2>批量遍历与 Stream API 的性能对比</h2>
<p>在处理 ArrayList 的批量读取或简单转换时,传统的索引循环或增强 for 循环通常比 Java 8 引入的 Stream API 更快。Stream 提供了函数式编程的便利,但其内部涉及迭代器的创建、中间操作的链式调用以及可能的装箱/拆箱开销。对于纯 CPU 密集型的遍历任务,直接操作底层数组或使用索引访问能减少这些隐式成本。</p><div class="aritcle_card flexRow artxards">
											<div class="artcardd flexRow">
												<a class="aritcle_card_img" rel="nofollow" href="/xiazai/skill12835" title="JavaScript 测试模式"><img
														src="https://img.php.cn/upload/skill/001/246/273/6adaf20cf0281539.jpg" alt="JavaScript 测试模式" onerror="this.onerror='';this.src='/static/lhimages/moren/morentu.png'" ></a>
												<div class="aritcle_card_info flexColumn">
													<a rel="nofollow" href="/xiazai/skill12835" title="JavaScript 测试模式" class="overflowclass">JavaScript 测试模式</a>
													<p class="overflowclass">使用 Jest、Vitest 和 Testing Library 实施全面的测试策略,包括单元测试、集成测试和端到端测试,涵盖模拟、测试夹具和测试驱动开发。在编</p>
												</div>
												<a rel="nofollow" href="/xiazai/skill12835" title="JavaScript 测试模式" class="aritcle_card_btn flexRow flexcenter"><b></b><span>下载</span>
												</a>
											</div>
										</div>
<p><img src="https://img.php.cn/upload/article/001/242/473/179470890445208.png?x-oss-process=image/resize,p_40" alt="Java ArrayList 批量操作性能怎么优化"></p>
<pre class="brush:php;toolbar:false;">import java.util.ArrayList;
import java.util.List;
import java.util.stream.Collectors;

public class TraversalPerformance {
    public static void main(String[] args) {
        List<integer> list = new ArrayList(100000);
        for (int i = 0; i <p>在上述示例中,<code>list.stream().mapToInt(...)</code> 会创建流管道,尽管 <code>mapToInt</code> 减少了装箱开销,但仍需处理流的状态管理。预期输出显示,<code>Index loop</code> 和 <code>Enhanced for</code> 的执行时间通常低于 <code>Stream</code>,特别是在数据量达到十万级别时。如果业务逻辑复杂,必须使用 Stream,可以考虑并行流 <code>parallelStream()</code>,但这会增加线程调度开销,仅在多核且数据量极大时才可能优于串行流。</p>
<h2>ArrayList 在并发修改下的 NoSuchElementException 问题</h2>
<p>在使用 Iterator 遍历 ArrayList 时,如果在遍历过程中直接调用 <code>list.remove()</code> 而非 <code>iterator.remove()</code>,会抛出 <code>ConcurrentModificationException</code>。这是因为 <code>ArrayList</code> 维护了一个 <code>modCount</code> 字段来检测结构性修改,每次增删元素都会增加该计数,而 Iterator 在初始化时记录了预期的 <code>modCount</code>,两者不一致即报错。这是批量操作中常见的运行时异常,需通过正确的删除接口规避。</p></integer>
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南



