






java jdbc 实现数据归档的核心做法是关闭自动提交,将查询和插入操作包裹在同一个事务中,并在成功时显式调用 commit,失败时调用 rollback。具体而言,通过 connection.setautocommit(false) 禁用默认行为,使用 preparedstatement 执行批量读取与写入,利用 try-catch-finally 块确保异常发生时回滚,并在 finally 中恢复自动提交或关闭连接。

JDBC 事务中如何保证批量操作的原子性
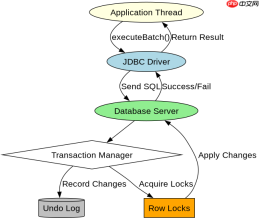
要保证批量操作的原子性,必须依赖数据库层面的事务隔离机制。在 Java 代码中,这意味着不能依赖默认的自动提交模式,而需要手动控制事务边界。当处理大量数据时,如果中间发生错误(如网络中断、约束冲突),整个批次的数据状态必须保持一致,要么全部归档,要么全部不归档。这通过 Connection 对象的 commit() 和 rollback() 方法实现,它们分别对应事务的提交和撤销操作。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.sql.SQLException;

public class ArchiveService {
    private static final String URL = "jdbc:mysql://localhost:3306/mydb";
    private static final String USER = "root";
    private static final String PASS = "password";

    public void archiveData(int batchSize) throws SQLException {
        Connection conn = null;
        try {
            // 1. 建立连接并关闭自动提交
            conn = DriverManager.getConnection(URL, USER, PASS);
            conn.setAutoCommit(false);

            // 2. 定义源表和目标表的 SQL
            String selectSql = "SELECT id, content FROM source_table WHERE archived = 0 LIMIT ?";
            String insertSql = "INSERT INTO archive_table (id, content) VALUES (?, ?)";
            String updateSql = "UPDATE source_table SET archived = 1 WHERE id = ?";

            PreparedStatement psSelect = conn.prepareStatement(selectSql);
            PreparedStatement psInsert = conn.prepareStatement(insertSql);
            PreparedStatement psUpdate = conn.prepareStatement(updateSql);

            psSelect.setInt(1, batchSize);
            ResultSet rs = psSelect.executeQuery();

            while (rs.next()) {
                int id = rs.getInt("id");
                String content = rs.getString("content");

                // 添加到目标表
                psInsert.setInt(1, id);
                psInsert.setString(2, content);
                psInsert.addBatch();

                // 标记源表已归档
                psUpdate.setInt(1, id);
                psUpdate.addBatch();
            }

            // 3. 执行批量操作
            psInsert.executeBatch();
            psUpdate.executeBatch();

            // 4. 提交事务
            conn.commit();
            System.out.println("Archive completed successfully.");

        } catch (SQLException e) {
            if (conn != null) {
                conn.rollback();
                System.err.println("Transaction rolled back due to error: " + e.getMessage());
            }
            throw e;
        } finally {
            if (conn != null) {
                conn.setAutoCommit(true); // 恢复默认
                conn.close();
            }
        }
    }
}
上述代码展示了完整的原子性保障流程。首先,setAutoCommit(false) 是关键步骤,它告诉数据库驱动接下来的所有操作都属于同一个事务单元。接着,使用 addBatch() 将多个 SQL 语句加入队列,最后通过 executeBatch() 一次性发送给数据库执行。如果在执行过程中任何一步抛出 SQLException,程序会进入 catch 块并调用 rollback(),从而撤销之前所有已执行的 DML 操作,确保数据一致性。finally 块中恢复 setAutoCommit(true) 是为了防止该连接被其他线程误用时的状态污染。
如何处理大事务中的内存溢出风险
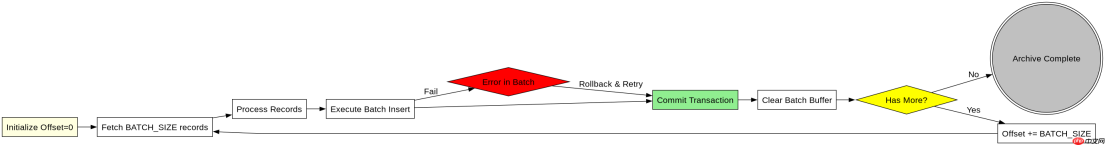
在处理数百万条数据进行归档时,将所有数据加载到内存或使用大型批量缓冲区会导致 OutOfMemoryError。解决这一问题的方法是采用分片策略,即在一个大事务内部,按固定数量(如 1000 条)进行小批量的提交与回滚管理,或者更常见的是,将大事务拆分为多个独立的小事务。但在严格的归档场景下,通常要求整批数据的逻辑一致性,因此更推荐的做法是使用游标流式读取结合分批提交,或者在应用层控制每次处理的记录数。然而,JDBC 标准事务不支持部分提交后继续同一事务,所以最佳实践是将“归档”视为一个由多个小事务组成的工作单元,每个小事务独立提交,若某一批次失败,仅重试该批次,而不影响其他已提交的批次。对于强一致性要求的单批归档,应限制单次事务的大小,例如每次只处理 5000 条记录,然后提交,再开始下一批。

import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.sql.ResultSet;
import java.sql.SQLException;

public class BatchedArchiveService {
    private static final String URL = "jdbc:mysql://localhost:3306/mydb";
    private static final String USER = "root";
    private static final String PASS = "password";
    private static final int BATCH_SIZE = 1000; // 每批处理1000条

    public void archiveInBatches() throws SQLException {
        Connection conn = null;
        try {
            conn = DriverManager.getConnection(URL, USER, PASS);
            conn.setAutoCommit(false);

            String selectSql = "SELECT id, content FROM source_table WHERE archived = 0 ORDER BY id LIMIT ? OFFSET ?";
            String insertSql = "INSERT INTO archive_table (id, content) VALUES (?, ?)";
            String updateSql = "UPDATE source_table SET archived = 1 WHERE id IN (...)"; // 简化示意

            PreparedStatement psSelect = conn.prepareStatement(selectSql);
            PreparedStatement psInsert = conn.prepareStatement(insertSql);

            int offset = 0;
            boolean hasMore = true;

            while (hasMore) {
                psSelect.setInt(1, BATCH_SIZE);
                psSelect.setInt(2, offset);
                ResultSet rs = psSelect.executeQuery();

                int count = 0;
                while (rs.next()) {
                    int id = rs.getInt("id");
                    String content = rs.getString("content");

                    psInsert.setInt(1, id);
                    psInsert.setString(2, content);
                    psInsert.addBatch();

                    count++;
                }
                rs.close();

                if (count > 0) {
                    psInsert.executeBatch();
                    conn.commit(); // 每批提交一次
                    System.out.println("Committed batch at offset: " + offset);
                } else {
                    hasMore = false;
                }

                offset += BATCH_SIZE;
                psInsert.clearBatch();
            }

        } catch (SQLException e) {
            if (conn != null) conn.rollback();
            throw e;
        } finally {
            if (conn != null) {
                conn.setAutoCommit(true);
                conn.close();
            }
        }
    }
}
此代码通过循环和偏移量(OFFSET)实现了分批处理。每次循环获取 BATCH_SIZE 条记录,执行插入后,立即调用 conn.commit() 提交当前批次。这样做的优点是即使某一批次失败,之前的批次已经持久化,不会导致全量重做。同时,由于每批事务较小,内存占用可控,避免了因大数据量导致的 OOM。需要注意的是,这种模式下,单个批次的原子性得到保证,但跨批次的整体一致性需由业务逻辑额外处理(如记录进度)。此外,clearBatch() 的使用确保了下一批开始时缓冲区为空,防止数据重复。
当源表主键冲突时归档操作会返回什么结果
当源表主键冲突时,归档操作会抛出 SQLException,具体为违反唯一约束的错误(如 MySQL 的 Duplicate entry)。此时,如果事务未提交,整个批次将被回滚,数据不会进入归档表,源表状态也不会改变。开发者需要在 catch 块中捕获此类异常,并根据业务需求决定是跳过该记录、重试还是终止任务。在实际运行中,若 archive_table 的主键与 source_table 相同,且存在历史残留数据,首次归档可能成功,但重复执行时会触发冲突。因此,建议在归档前检查目标表是否已存在该 ID,或在插入时使用 INSERT IGNORE 或 ON DUPLICATE KEY UPDATE 语法来避免异常中断事务。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


