






array_chunk()如何替代取余逻辑进行分组
使用array_chunk()替代取余(%)逻辑的核心在于将“按索引位置判断”转变为“按数据块大小切分”。取余通常用于在遍历数组时,根据当前索引是否能被特定数值整除来执行不同操作或插入分隔符;而array_chunk()则是直接将原数组切割成指定长度的子数组集合。若你的目标是生成固定大小的数据块以便批量处理或前端展示,直接调用该函数并设置$preserve_keys参数即可,无需手动维护计数器。
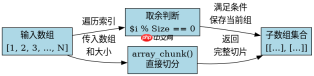
从循环内判断到整体切分的代码重构
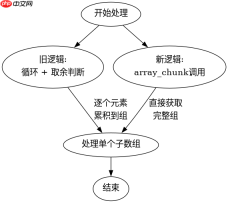
当需要将原本在for或foreach中通过$i % $size == 0触发的逻辑(如开启新行、重置状态)迁移至array_chunk()时,应将触发条件移至对每个子数组的处理上。这意味着不再依赖全局索引的模运算,而是针对切分后的每一个独立子数组执行相同的业务逻辑。这种改法消除了对索引变量的依赖,使代码更专注于数据本身的结构。
$data = range(1, 13);
$chunkSize = 5;

// 旧逻辑:使用取余判断是否换行或重置
$result_old = [];
$current_group = [];
foreach ($data as $index => $value) {
    if ($index > 0 && $index % $chunkSize === 0) {
        $result_old[] = $current_group;
        $current_group = [];
    }
    $current_group[] = $value;
}
if (!empty($current_group)) {
    $result_old[] = $current_group;
}
print_r($result_old); // 输出包含多个子数组的二维数组

// 新逻辑:直接使用 array_chunk
$result_new = array_chunk($data, $chunkSize, false);
print_r($result_new); // 输出结构与上面完全一致
上述代码展示了两种实现方式的等价性。旧逻辑中,$index % $chunkSize === 0用于检测何时应该结束当前组并开始新的一组。在新逻辑中,array_chunk内部自动完成了这一分割过程。对于最后不足$chunkSize的部分,两者均会将其作为最后一个子数组保留,行为保持一致。开发者只需关注最终生成的二维数组结构,而无需关心内部的边界判断。

处理非均匀数据时的边界情况与键值保留
在使用array_chunk()时,一个关键的区别在于默认行为会重置子数组的键名为从0开始的连续整数。如果原始数据依赖于关联键(如ID或名称),且后续逻辑需要保留这些原始键名以维持数据完整性,则必须显式设置第三个参数为true。这与取余逻辑不同,取余逻辑通常只访问当前元素的值或通过索引获取,不直接涉及键名的映射关系,因此在使用array_chunk时需特别注意此参数以避免数据丢失或键冲突。
$assocData = ['a' => 1, 'b' => 2, 'c' => 3, 'd' => 4];

// 默认行为:键名重置为 0, 1
$resetKeys = array_chunk($assocData, 2);
// 结果: [[0=>1, 1=>2], [0=>3, 1=>4]]

// 保留原始键名
$keepKeys = array_chunk($assocData, 2, true);
// 结果: [['a'=>1, 'b'=>2], ['c'=>3, 'd'=>4]]
在实际开发中,若之前的取余逻辑配合了$array[$i]这样的索引访问,切换后应确保后续代码适配新的二维数组结构。例如,若之前通过$i % 2来判断奇偶性并赋予不同样式,现在应先遍历子数组,再在子数组内部遍历元素。若需保持原有的“每N个元素一组”的视觉或逻辑分组,array_chunk是更简洁的选择,但务必检查是否需要保留原始键名,这取决于下游处理逻辑对数据标识符的依赖程度。
php免费学习视频:立即使用
踏上前端学习之旅,开启通往精通之路!从前端基础到项目实战,循序渐进,一步一个脚印,迈向巅峰!





