当skip数值很大时,分页查询变慢是因为数据库必须物理扫描并丢弃前n条记录才能返回剩余数据,导致i/o和cpu开销随偏移量线性增长。解决这一问题的核心做法是改用基于索引的游标分页(keyset pagination),即利用上一页最后一条记录的排序键值作为下一页的查询条件,从而将时间复杂度从o(n)降低为o(log n)。这种方案依赖于排序字段具备唯一性或组合唯一性,且必须在排序列上建立合适的索引。

为什么大偏移量会导致性能急剧下降?
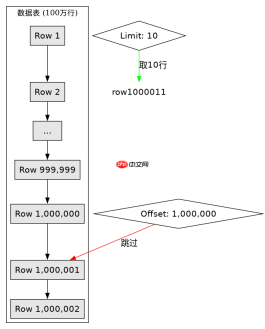
大偏移量导致性能下降的根本原因在于传统分页机制无法跳过已扫描的数据。在SQL Server、MySQL等主流数据库中,执行`OFFSET 1000000 LIMIT 10`这类语句时,数据库引擎必须先读取满足WHERE条件的1,000,001行数据,然后在内存中丢弃前1,000,000行,仅返回最后10行。如果数据表没有覆盖索引,这通常意味着大量的随机磁盘I/O操作;即使有覆盖索引,也需要遍历B+树的大量节点。随着Offset值的增加,需要扫描的行数成倍增加,查询耗时也随之线性上升。
SELECT * FROM Orders
ORDER BY OrderId ASC
OFFSET 100000 ROWS FETCH NEXT 10 ROWS ONLY;
上述代码展示了典型的深度分页场景。假设OrderId是自增主键,数据库仍需按顺序扫描前10万行。若此时添加一个非聚集索引,虽然减少了回表开销,但依然需要遍历索引树的叶子节点来计数和跳过,效率提升有限。对于千万级数据量的表,这种查询往往需要数秒甚至更久,严重影响用户体验。
如何使用游标分页优化大数量查询?
游标分页通过记录上一次查询的最后位置来避免重复扫描。具体做法是在第一次查询获取最后一条记录的排序键值,后续查询使用该键值作为过滤条件。例如,若上次查询最后一条记录的OrderId为50000,则下一页查询条件为`WHERE OrderId > 50000 ORDER BY OrderId ASC LIMIT 10`。这种方式直接定位到目标起始位置,无需扫描中间数据,查询速度几乎恒定,与当前页码无关。


SELECT * FROM Orders
WHERE OrderId > 50000
ORDER BY OrderId ASC
LIMIT 10;
该代码片段演示了游标分页的实际应用。关键在于确保排序键是唯一的,或者使用复合唯一键(如UserId + OrderId)来保证结果集的顺序确定性。如果存在相同键值的情况,需进一步细化排序规则以避免数据遗漏或重复。此方法要求前端传递上一页的最后一个ID,而非页码,因此不支持直接跳转到任意页,但在列表浏览场景下表现优异。
当排序字段存在重复值时如何处理?
当排序字段存在重复值时,单纯使用`WHERE Key > LastValue`可能导致数据遗漏或不稳定。例如,若多条记录具有相同的CreateTime,仅靠时间判断可能无法准确界定边界。解决方法是引入辅助排序键,构建复合排序条件。具体而言,在WHERE子句中同时比较主排序键和次排序键,确保每一行数据的唯一性和顺序一致性。这样即使主键重复,也能通过次键精确区分,保证分页结果的完整性和准确性。