在 apache 中判断 http_referer 是否来自搜索引擎,核心做法是使用 rewritecond 指令配合正则表达式匹配 %{http_referer} 变量。通过定义包含常见搜索引擎域名(如 google.com、baidu.com)的正则模式,并设置 [nc] 标志忽略大小写,即可准确识别来源。若请求头为空或无法解析,通常视为非搜索引擎流量。

如何配置正则以覆盖主流搜索引擎?
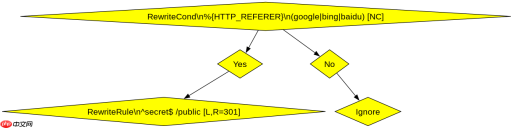
要覆盖主流搜索引擎,需要在 RewriteCond 中使用 | 符号连接多个域名关键词。例如,匹配 Google、Bing 和 Baidu 的完整正则表达式为 (google|bing|baidu)。此配置会检查 HTTP_REFERER 中是否包含这些子串,从而判定流量来源。
# 启用重写引擎
RewriteEngine On

# 条件:Referer 包含特定搜索引擎关键词,忽略大小写
RewriteCond %{HTTP_REFERER} (google|bing|baidu) [NC]

# 规则:如果满足上述条件,将 /secret 重定向到 /public
RewriteRule ^secret$ /public [L,R=301]
上述代码中,RewriteCond 首先检查 %{HTTP_REFERER}。如果用户是从 Google 搜索进入,Referer 可能为 https://www.google.com/search?q=test,正则 (google|bing|baidu) 能成功匹配 google 部分。此时 RewriteRule 生效,执行重定向。若 Referer 为空(如直接访问或书签),正则不匹配,规则跳过。
如何处理非标准搜索引擎或自定义爬虫?
对于非标准搜索引擎或内部自定义爬虫,可以通过扩展正则表达式中的域名列表来实现。例如,添加 yahoo 或自定义域名 my-crawler.com。此外,需注意某些隐私设置较强的浏览器或工具可能会隐藏 Referer,导致误判为非搜索引擎。

通过Apache Tika Server REST API从1400多种文件格式中提取文本和元数据。处理PDF、DOCX、PPTX、电子邮件归档以及带有MIME类型检测的嵌入式文档提取。

# 启用重写引擎
RewriteEngine On

# 条件:Referer 包含更广泛的搜索引擎或自定义爬虫
RewriteCond %{HTTP_REFERER} (google|bing|baidu|yahoo|my-crawler\.com) [NC]

# 规则:允许访问受保护的资源
RewriteRule ^protected/.*$ - [L]
在第二个示例中,正则表达式扩展为 (google|bing|baidu|yahoo|my-crawler\.com)。注意 . 在正则中需转义为 \. 以匹配字面量点号。当 HTTP_REFERER 为 http://my-crawler.com/spider 时,匹配成功,RewriteRule 允许访问 /protected/ 下的资源。若 Referer 为 https://example.com/page,则不匹配,规则不执行。
当 HTTP_REFERER 缺失时如何区分直接访问与搜索引擎?
当 HTTP_REFERER 缺失时,Apache 默认将其视为空字符串,正则表达式无法匹配任何内容,因此不会触发针对搜索引擎的规则。这意味着直接访问、书签打开或隐私模式下的请求会被排除在搜索引擎逻辑之外。若需明确处理此类情况,可添加额外的 RewriteCond 检查 %{HTTP_REFERER} 是否为空。
# 启用重写引擎
RewriteEngine On

# 条件1:Referer 为空
RewriteCond %{HTTP_REFERER} ^$

# 规则1:直接访问时记录日志
RewriteRule ^(.*)$ - [E=DIRECT_ACCESS:yes,L]
此段代码专门处理 HTTP_REFERER 为空的情况。通过 RewriteCond %{HTTP_REFERER} ^$ 匹配空字符串,设置环境变量 DIRECT_ACCESS 为 yes。这有助于区分直接访问与搜索引擎流量,因为搜索引擎通常提供有效的 Referer。结合之前的搜索引擎规则,可实现更精细的流量控制。