






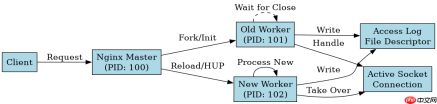
排查 nginx 平滑重载后内存未释放,核心思路是确认当前进程是否仍持有旧连接或文件描述符。通过 kill -hup 触发重载后,主进程会启动新的工作进程,但旧的工作进程不会立即退出,而是继续处理完现有的请求。如果内存占用持续不降,通常是因为旧进程还在运行,或者新进程未能正确接管资源。此时应使用 ps aux 查看进程状态,结合 lsof 检查文件句柄,并观察 /proc/[pid]/status 中的内存指标。
如何判断旧工作进程是否仍在处理请求
判断旧工作进程是否存活,最直接的方法是检查其进程状态和打开的文件描述符。Nginx 在收到 HUP 信号后,主进程会重新加载配置文件并启动新工作进程,旧工作进程进入 "graceful shutdown" 模式。只要还有活跃连接,旧进程就不会退出。可以通过 ps -eo pid,stat,comm | grep nginx 筛选出所有 Nginx 相关进程,重点关注状态为 S (睡眠) 且非 Z (僵尸) 的进程。如果旧进程的 TIME 字段不再增加,说明它已停止处理新请求,但仍可能因等待旧连接关闭而占用内存。
#!/bin/bash
# 获取 Nginx 主进程 PID
MASTER_PID=$(cat /var/run/nginx.pid)
echo "Master PID: $MASTER_PID"

# 列出所有 Nginx 进程及其状态
ps -eo pid,ppid,stat,time,comm | grep nginx | grep -v grep

# 检查旧工作进程打开的文件数
for PID in $(ps -eo pid | grep nginx | awk 'NR>1{print $1}'); do
    echo "PID $PID open files: $(ls /proc/$PID/fd | wc -l)"
done

# 监控内存变化
watch -n 1 'ps -eo pid,rss,comm | grep nginx'
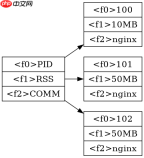
上述脚本首先读取主进程 PID,然后列出所有子进程的状态。重点观察是否有多个 worker 进程同时存在。如果新旧进程并存,且旧进程的 RSS(物理内存)没有随时间减少,说明旧连接尚未完全断开。通过 ls /proc/$PID/fd 可以查看每个进程打开的文件描述符数量,如果数量异常高,可能是连接泄漏或未正确关闭。
如何通过 lsof 分析文件描述符泄漏
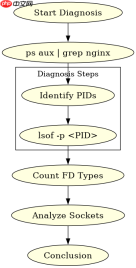
当怀疑内存未释放是由于文件描述符泄漏时,lsof 是关键的诊断工具。Nginx 工作进程会打开大量的 socket、日志文件和缓存文件。如果旧进程未能正确关闭这些文件,它们会一直占用内核资源和内存。使用 lsof -p 可以列出指定进程打开的所有文件。特别关注类型为 IPv4 或 IPv6 的 sock 节点,以及 REG(常规文件)类型。如果发现大量处于 ESTABLISHED 状态的 socket,且对应的时间戳显示它们是在重载前建立的,那么这些就是导致旧进程内存不释放的原因。

# 假设旧工作进程 PID 为 12345
lsof -p 12345 | head -20

# 统计不同类型的文件描述符数量
lsof -p 12345 | awk '{print $5}' | sort | uniq -c | sort -nr

# 检查特定端口的连接
lsof -i :80 -p 12345
执行 lsof -p 12345 后,输出结果中每一行代表一个打开的文件描述符。通过统计 TYPE 列(第5列),可以快速了解进程打开了多少 socket、文件或目录。如果 sock 类型的数量远大于预期,且这些 socket 对应的 NAME 列显示为 ESTABLISHED,则说明有活跃连接未被释放。此外,检查 COMMAND 列是否为 nginx,确保分析的是正确的进程。如果旧进程已经退出了,lsof 将返回空结果,此时内存未释放的问题可能源于新进程配置不当或系统级问题。
为什么 reload 后 worker 进程数量会增加
Nginx 在执行 reload 操作时,主进程会 fork 出新的工作进程,而旧的工作进程会继续处理完当前的请求后才退出。因此,在短时间内,系统中会出现新旧两组工作进程,导致总进程数暂时增加。这是 Nginx 实现零停机重载的机制。如果 nginx.conf 中配置的 worker_processes 为 auto 或具体数值,新启动的进程数量将与配置一致。旧进程在退出前,会将其持有的连接传递给新进程(如果配置了 accept_mutex 等参数),或者在新进程启动后逐渐关闭自己的连接。这个过程可能导致内存占用出现短暂的峰值,随后随着旧进程的退出而回落。如果旧进程长时间不退出,可能需要检查是否有阻塞的 I/O 操作或网络延迟。





