






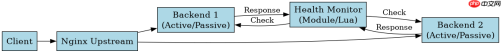
在 nginx 中配置 upstream 健康检查参数,核心在于使用第三方模块(如 `nginx-upstream-healthcheck`)或结合 lua 脚本(如 openresty),因为标准 nginx 仅支持被动健康检查。具体做法是定义一个 `upstream` 块,在其中引入健康检查指令,设置检查间隔、超时时间、失败阈值等参数,从而实现对后端服务器的主动监控和自动剔除。
如何配置被动健康检查的基本参数
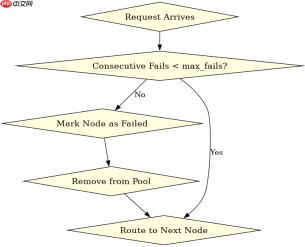
被动健康检查通过标记故障节点来实现,无需额外模块。只需在 `upstream` 块中为每个 `server` 添加 `max_fails` 和 `fail_timeout` 参数即可。`max_fails` 定义在 `fail_timeout` 时间内允许的最大失败次数,超过后该节点将被暂时剔除。例如,设置 `max_fails=3` 和 `fail_timeout=30s`,意味着如果 30 秒内连接失败 3 次,Nginx 会在接下来的 30 秒内不再向该节点发送请求。
upstream backend {
    server 192.168.1.10:8080 max_fails=3 fail_timeout=30s;
    server 192.168.1.11:8080 max_fails=3 fail_timeout=30s;
}
上述配置中,两个后端服务器均启用了被动检查。当客户端请求到达时,若某节点连续失败达到阈值,Nginx 会自动将其从可用列表中移除,直到 `fail_timeout` 结束后才重新尝试。这种机制简单有效,但存在延迟,因为只有在有流量经过时才能发现故障。
如何实现主动健康检查的高级配置
主动健康检查需要借助第三方模块,如 `nginx-upstream-healthcheck`。该模块允许 Nginx 定期向后端发送探测请求,根据响应状态判断节点健康度。配置时需加载模块,并在 `upstream` 块中使用 `health_check` 指令。可以指定检查的 URI、间隔时间、超时时间和匹配条件。例如,设置每 5 秒检查一次 `/health` 接口,超时时间为 2 秒,若返回非 200 状态码则标记为故障。


upstream backend {
    server 192.168.1.10:8080;
    server 192.168.1.11:8080;
    health_check uri=/health interval=5 timeout=2;
}
此配置中,Nginx 会主动向每个后端发送 GET 请求到 `/health` 路径。如果节点在 2 秒内未响应或返回错误状态,它将被标记为不可用。主动检查能更快发现故障,减少用户受影响的时间,但会增加 Nginx 自身的负载。确保后端应用提供轻量级的健康检查接口,以避免不必要的资源消耗。
基于 health_check 指令中 interval 参数的具体影响
在主动健康检查配置中,`interval` 参数决定了检查的频率。若将 `interval` 设置为较小值(如 1 秒),Nginx 会更频繁地探测后端,从而更快地发现并剔除故障节点,但也会增加网络开销和 CPU 使用率。反之,若设置为较大值(如 30 秒),检查频率降低,系统负载减轻,但故障恢复时间会变长。实际应用中,需根据业务对实时性的要求和后端承受能力进行权衡。例如,对于高可用性要求极高的场景,可设置 `interval=5` 以平衡检测速度与资源消耗;而对于低流量服务,可适当增大间隔以减少无效请求。


