






排查 nginx 后端服务假死导致的代理超时,核心在于区分是网络层面的连接中断还是应用层面的响应停滞。具体做法是调整 proxy_read_timeout 参数以缩短等待时间,并配合 proxy_next_upstream 启用故障转移或返回明确的错误页。通过观察 nginx 的 error.log 中是否出现 upstream timed out 记录,可以确认是否为超时问题。
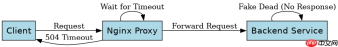
Nginx 如何配置超时与重试机制
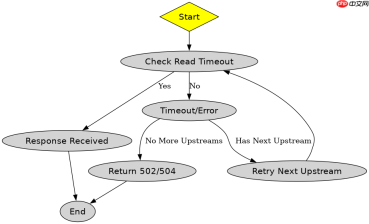
要解决后端假死导致的长时间挂起,必须显式设置读取超时时间并启用自动重试。在 location 块中配置 proxy_read_timeout 为较短的值(如 5s),并将 proxy_next_upstream 设置为 timeout error,这样当第一个后端无响应时,Nginx 会立即尝试下一个后端或直接报错,而不是无限期等待。
server {
    listen 80;
    location /api/ {
        proxy_pass http://backend_pool;
        # 设置读取超时时间为 5 秒
        proxy_read_timeout 5s;
        # 发生超时或错误时,尝试下一个上游服务器
        proxy_next_upstream timeout error;
        # 如果所有后端都失败,返回 502 或 504
        proxy_next_upstream_tries 2;
    }
}
如何通过日志定位具体的超时节点
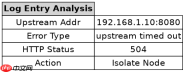
定位问题的关键在于分析 Nginx 的错误日志。当后端假死时,Nginx 会在 error.log 中记录 [error] ... upstream timed out (110: Connection timed out) while reading response header from upstream。通过 grep 搜索该关键字,并结合 $upstream_addr 变量,可以精确找出是哪个后端 IP 导致了超时,从而隔离故障节点。

# 在 server 块中添加日志格式以包含上游地址
log_format main '$remote_addr - $remote_user [$time_local] "$request" '
                '$status $body_bytes_sent "$http_referer" '
                '"$http_user_agent" upstream=$upstream_addr';

# 查看日志命令示例
nginx -s reload
# 随后执行请求,并检查 error.log
grep "upstream timed out" /var/log/nginx/error.log | tail -n 20
后端假死时 Nginx 的连接状态变化
当后端服务假死但 TCP 连接未断开时,Nginx 会保持连接处于 ESTABLISHED 状态,直到 proxy_read_timeout 触发。此时,Nginx 不会主动关闭连接,而是等待后端数据。一旦超时,Nginx 会发送 RST 包重置连接,并向客户端返回 504 Gateway Time-out。这种状态变化可以通过 netstat 或 ss 命令观察到大量的 TIME_WAIT 或 CLOSE_WAIT 连接,表明 Nginx 正在处理积压的请求。





