






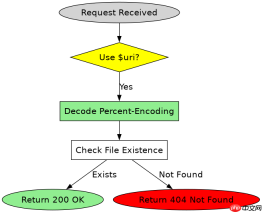
nginx 的 try_files 指令在处理带空格或中文的文件名时,必须依赖 nginx 内部变量(如 $uri)进行自动 url 解码,而不能直接使用客户端传入的原始路径字符串。如果直接拼接包含特殊字符的路径,nginx 会将其视为字面量导致匹配失败;通过引用内置变量,nginx 会在内部将百分号编码(如 %20 或 %e4%b8%ad%e6%96%87)转换为文件系统所需的 utf-8 字节序列,从而正确定位文件。
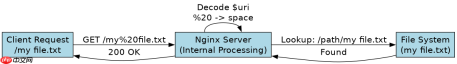
为什么直接引用 $request_uri 会导致匹配失败?
当用户请求带有空格或中文的 URL 时,浏览器会自动对非 ASCII 字符进行百分号编码。如果在 try_files 中直接使用 $request_uri 或手动拼接未解码的字符串,Nginx 会将这些编码字符(如 %20)当作文件名的一部分去磁盘查找,而操作系统上的文件名通常是 UTF-8 编码的纯文本,两者不匹配就会返回 404。此外,Nginx 在解析配置时,如果路径中包含空格且未被正确引用,可能会引发语法解析错误。
server {
    listen 80;
    server_name example.com;
    root /var/www/html;

    # 错误写法:直接使用 $request_uri,包含 %20 或 %E4... 等编码
    location /files/ {
        try_files $request_uri =404;
    }

    # 正确写法:使用 $uri,Nginx 内部已解码
    location /files/ {
        try_files $uri $uri/ =404;
    }
}
上述代码展示了两种不同的配置方式。第一种尝试直接使用原始 URI,这在处理 http://example.com/files/my file.txt 时会失败,因为 Nginx 会在磁盘上寻找名为 my%20file.txt 的文件。第二种方式使用 $uri,这是 Nginx 经过内部处理后、去除查询参数并解码后的 URI,它直接对应磁盘上的实际文件名路径,因此能正确找到 my file.txt 或 中文文件.txt。
如何处理多级目录中的复杂中文路径?
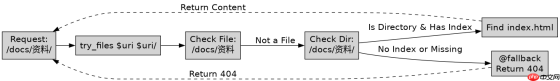
在处理深层嵌套的中文目录结构时,除了使用 $uri,还需要注意 try_files 的 fallback 机制和目录遍历行为。如果请求的是一个包含中文的目录,例如 /docs/资料/,Nginx 需要确认该目录是否存在以及是否启用了索引。直接使用 $uri 可以确保路径解码的一致性,但必须配合 $uri/ 来显式指示 Nginx 检查对应的目录。如果目录不存在,或者目录中没有默认索引文件(如 index.html),Nginx 会根据配置的 fallback 规则返回错误。

server {
    listen 80;
    server_name example.com;
    root /var/www/html;

    location /docs/ {
        # 先尝试精确匹配文件,再尝试匹配目录
        try_files $uri $uri/ @fallback;
    }

    location @fallback {
        return 404 "File or directory not found";
    }
}
这段配置针对 /docs/ 下的所有资源进行了优化。当请求 /docs/我的文件夹/图片.png 时,$uri 会被解码为 /docs/我的文件夹/图片.png,Nginx 随后在根目录下查找该路径。如果这是一个文件且存在,则直接返回;如果是一个目录,$uri/ 会触发目录检查。这种处理方式避免了手动构造路径时的编码陷阱,确保了中文路径在不同操作系统和 Nginx 版本间的一致性。
基于 $uri 变量解码行为的潜在问题是什么?
虽然 $uri 提供了自动解码功能,但它也会移除 URL 中的查询字符串(query string)。如果业务逻辑依赖于保留查询参数,仅靠 $uri 是不够的,需要结合 $is_args 和 $args 重新拼接。此外,如果文件名中包含 Nginx 认为非法的字符组合,即使解码后也可能被拒绝。最关键的潜在问题是,$uri的解码行为依赖于 Nginx 内部的标准化流程,如果路径中存在双编码(double encoding)情况,Nginx 可能不会完全还原原始意图,导致安全过滤绕过或路径遍历漏洞。因此,对于关键业务,建议在应用层进行额外的路径校验。


