输入首批待入库的本地文件、网页链接或聊天记录,关键操作是筛选高价值样本并验证读取稳定性,产出为可稳定检索且能辅助 AI 输出的最小可行知识库集。新手常犯的错误是一开始就试图将所有收藏、网页和本地文档一次性全部导入,这种做法看似内容充实,实则容易堆砌无效信息,导致后续检索噪音过大。建议将首批入库资料控制在少量范围内,通过代表性样本来测试系统能力,而非追求数量。
如何确定首批入库的数量与类型?
首批资料不宜过多,核心原则是“少而精”。建议将初始入库量控制在20条以内,以此作为测试基准。这个数量足以覆盖不同格式,又不会造成系统负担或检索混乱。你需要从日常积累中挑选出近期确实会用到、且有实质内容的材料,避免将历史垃圾数据带入新库。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
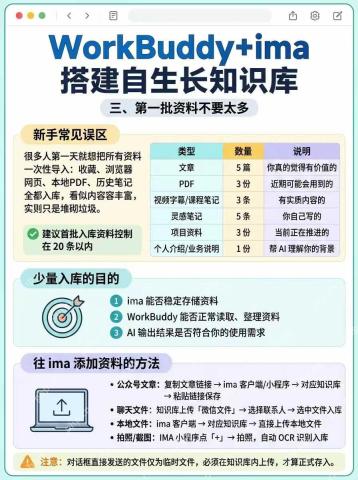
为了全面验证系统的兼容性,选材应涵盖多种常见格式。具体建议如下: - 文章类:选取5篇近期有价值的公众号或网络文章,用于测试链接抓取和正文解析。 - PDF类:选取3份包含实质内容的文档,如报告或手册,验证复杂排版文件的读取。 - 视频字幕或课程笔记:选取3条,测试非结构化文本的处理能力。 - 灵感笔记:选取5条你自己撰写的碎片化想法,检验短文本的存储效果。 - 项目资料:选取3份当前正在推进的项目相关文件,确保业务连续性。 - 个人介绍或业务说明:选取1份,帮助AI理解你的背景信息,提升回答的相关性。
怎样验证不同来源的资料能否正常入库?
选材完成后,必须对每种类型的资料进行实际导入测试,确保 WorkBuddy 或 ima 客户端能正确读取并整理。不要假设所有文件都能完美兼容,特别是经过OCR识别的图片或特殊格式的PDF。
- 公众号文章:复制文章链接,在 ima 客户端或小程序中找到对应知识库,粘贴链接并保存。检查是否能完整提取正文。
- 聊天文件:在知识库中上传微信文件,选择联系人并选中文件入库。确认文件未被截断或乱码。
- 本地文件:直接在 ima 客户端的对应知识库中上传本地文件。观察上传进度及解析后的预览是否正常。
- 拍照或截图:使用 ima 小程序点击“+”号进行拍照,系统会自动进行OCR识别并入库。核对识别文字是否准确。
特别注意,对话框直接发送的文件仅为临时文件,必须在知识库内执行上传操作,才算正式存入。只有经过入库流程的文件,才能被后续的检索和AI分析功能调用。如果某类文件在测试中出现读取失败或内容缺失,应从首批名单中剔除,直到找到能稳定支持的替代方案。

员工在试用 WorkBuddy 时,经常会冒出"这个要是能一键就好了"的念头,但往往转头就忘。本技能把这类反馈零摩擦地沉淀到企业统一表格: 1. 不用跳出当前工作流、不用重复填姓名和部门; 2. 身份一次配置,后续只说内容即可; 3. 自动对齐表头、追加一行,企业方可直接统计。 触发方式 在对话中表达"提交 / 记录一条反馈"的意图即可触发,例如: - 反馈一个需求 · 提个诉求 · 记录一下这个痛点 - 收集反馈 · 提交体验反馈 · feedback - 完成
为什么不建议一次性导入所有资料?
一次性导入大量杂乱资料会导致知识库变成“垃圾堆”,不仅占用存储空间,还会干扰AI的输出质量。当检索范围过大时,相关度高的信息容易被淹没,导致AI引用错误或非核心的内容。
通过控制首批数量,你可以清晰地观察到AI是如何处理不同类型信息的,以及输出结果是否符合你的使用需求。这种小步快跑的方式,能让你在早期发现并修正问题,比如调整文件格式或优化标签,从而搭建一个真正自生长、高质量的知识库基础。