选择云服务器规格时,核心原则是匹配业务负载特征。对于大多数 web 应用和 api 服务,通用型实例(如 1:4 cpu 与内存比)是起步首选;若涉及大量实时计算或游戏逻辑,应选计算型(1:2);而处理 redis、elasticsearch 等内存数据库时,则需内存型(1:8)。避免盲目追求高配,应根据实际监控数据动态调整。
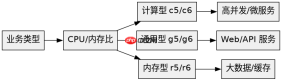
负载特征与实例族匹配
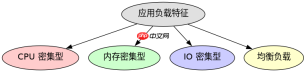
不同业务对硬件资源的消耗模式存在显著差异。CPU 密集型任务(如视频转码、科学计算)需要极高的处理器频率和多核并行能力,此时应优先保证 vCPU 数量。内存密集型任务(如大数据分析、内存缓存)则受限于 RAM 容量,过小的内存会导致频繁的 Swap 交换,严重拖慢性能。IO 密集型任务(如日志处理、文件存储)更依赖磁盘吞吐和网络带宽,而非单纯的计算能力。
在实际操作中,建议先通过压测工具模拟真实流量,观察 CPU 使用率、内存占用和 IO 等待时间。若 CPU 长期低于 20% 而内存接近上限,说明当前配置属于“大马拉小车”,可降级为内存型实例以节省成本。反之,若 CPU 持续满载且响应延迟增加,则需升级至计算型实例或增加节点数量。云厂商通常提供按量付费和包年包月两种模式,初期测试建议使用按量付费,稳定后转为包年包月以获得折扣。
分布式架构下的资源规划
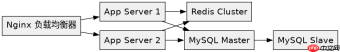
当单体应用无法满足需求时,通常会转向分布式架构。此时,各组件的资源需求不再单一,而是呈现多元化分布。例如,一个典型的电商系统包含前端网关、后端业务服务器、缓存集群和关系型数据库。每个组件的规格选择需独立评估,并通过负载均衡器进行流量分发。
IT技术解决互联网公司网站模板是一款适合提供APP设计、网页开发、SEO优化、云服务、数据分析等服务的互联网公司宣传网站模板下载。提示:本模板调用到谷歌字体库,可能会出现页面打开比较缓慢。
# Python Flask 示例:模拟多节点请求分发
from flask import Flask, request
import random

app = Flask(__name__)

# 模拟后端服务列表
backend_servers = ['192.168.1.10', '192.168.1.11']

@app.route('/api/data')
def get_data():
    # 简单轮询算法分发请求
    server = random.choice(backend_servers)
    return f"Response from {server}"

if __name__ == '__main__':
    # 启动服务,监听 8080 端口
    app.run(host='0.0.0.0', port=8080, debug=False)
上述代码展示了一个简单的 Flask 应用,用于模拟后端服务接收请求。在实际部署中,该应用应运行在多台通用型实例上,前方由 Nginx 或云 LB 进行负载均衡。Redis 集群应部署在内存型实例上,以利用其大容量低延迟特性。MySQL 主从架构中,主库可选用高 IO 优化的实例,从库则可根据读压力扩展只读节点。运行此代码前,需安装 Flask 库(pip install flask),然后通过 curl 多次访问 http://localhost:8080/api/data 观察响应来源的变化。这种架构允许单独扩容某一类资源,而不必整体升级所有服务器。
突发性能实例的成本陷阱
许多用户倾向于选择突发性能实例(如 t5/t6 系列),因为其初始价格极低。这类实例采用 CPU 积分机制:空闲时积累积分,使用时消耗积分。当积分耗尽时,CPU 性能会被限制在基准水平(通常为 10%-20%),导致应用响应极慢甚至超时。对于 Web 服务而言,短暂的流量高峰即可耗尽积分,造成用户体验下降。因此,除非是开发测试环境或夜间批处理任务,否则生产环境应避免使用突发性能实例。建议在选型阶段查阅云厂商的 CPU 积分模型文档,计算预期峰值负载所需的积分速率,确保不会频繁触发限流。