






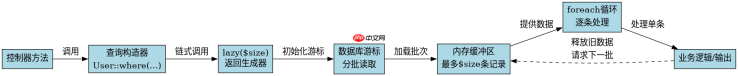
thinkphp8.1.4中,使用lazy惰性查询和stream流式处理的核心方法是调用模型或查询构造器的lazy()方法并传入参数。具体做法是:在获取大量数据时,调用$query->lazy($chunksize),其中$chunksize指定每次从数据库游标中读取的记录数量(如1000)。这样做可以避免一次性将所有数据加载到内存中,从而显著降低内存占用,适用于导出excel、大数据量报表等场景。
如何配置lazy查询的批次大小以平衡内存与性能
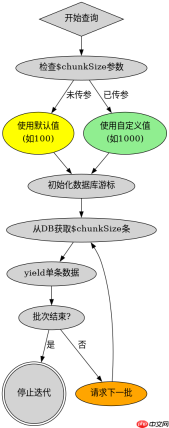
要配置lazy查询的批次大小,只需在调用lazy()方法时传入一个整数参数即可。例如,User::where('status', 1)->lazy(500)表示每次从数据库提取500条记录。这个参数直接决定了内存缓冲区的最大行数,设置过小会增加数据库交互次数,设置过大则失去流式处理的内存优势。默认情况下,如果不传参,ThinkPHP通常使用内部默认值(通常为100或取决于驱动),但显式指定能确保行为一致。
use app\model\User;

// 假设User模型已定义
$query = User::where('status', 1);

// 设置批次大小为1000
$cursor = $query->lazy(1000);

foreach ($cursor as $user) {
    // 处理单条数据
    echo $user->name . PHP_EOL;
}
上述代码中,lazy(1000)返回一个生成器对象。在foreach循环中,只有当需要下一条数据时,才会向数据库发起请求获取下一批1000条记录。处理完当前批次后,内存中的旧数据会被释放,从而实现低内存占用。预期结果是:无论数据库中有1万条还是100万条符合条件的记录,内存峰值仅维持在约1000条记录的规模。
stream流式输出在Web响应中如何实现
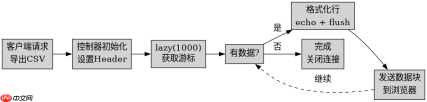
在Web应用中实现stream流式处理,需要将lazy查询的结果直接输出到HTTP响应流中,而不是构建完整的数组或集合。具体做法是:在控制器中,初始化HTTP响应为流模式,然后遍历lazy查询结果,逐条写入响应体并刷新缓冲区。这允许用户在数据完全生成前就能看到部分结果,提升大文件导出的用户体验。

use think\facade\Response;
use app\model\User;

public function exportUsers()
{
    // 设置响应头,告知浏览器这是流式内容
    Response::contentType('text/csv');
    Response::header('Content-Disposition', 'attachment; filename="users.csv"');

    // 获取lazy查询游标
    $cursor = User::where('status', 1)->lazy(1000);

    // 输出CSV头部
    echo "id,name,status\r\n";

    // 逐条处理并输出
    foreach ($cursor as $user) {
        echo sprintf("%d,%s,%d\r\n", $user->id, $user->name, $user->status);
        // 刷新输出缓冲区,确保数据立即发送给客户端
        flush();
    }

    return Response::create();
}
在上述代码中,flush()函数是关键,它强制将PHP的输出缓冲区内容发送到客户端。结合lazy(1000),服务器不会等待所有用户数据处理完毕才响应,而是边查边写。注意:在生产环境中,需确保Web服务器(如Nginx)未启用缓冲,否则flush()可能无效。此外,对于超大数据集,建议配合队列任务异步生成,避免请求超时。
lazy查询在处理空结果集时的行为是什么
当lazy查询的条件没有匹配任何记录时,lazy()方法返回的生成器不会抛出异常,也不会触发任何数据库查询(取决于驱动优化),而是直接结束迭代。这意味着foreach循环体一次都不会执行。开发者无需额外判断结果是否为空,因为生成器的自然行为已处理了这种情况。若需验证是否真的无数据,可在循环外设置标志位,或在循环内计数。
php免费学习视频:立即使用
踏上前端学习之旅,开启通往精通之路!从前端基础到项目实战,循序渐进,一步一个脚印,迈向巅峰!





