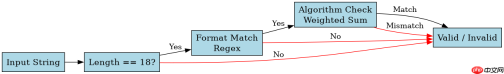
在 spring boot 中校验统一社会信用代码,最稳妥的做法是结合 jsr-303/380 标准注解与自定义正则表达式。直接调用 @pattern 并配置符合 gb 32100-2015 标准的正则即可实现格式校验,若需确保代码真实有效,可在此基础上增加校验算法逻辑。
如何定义通用的信用代码校验注解
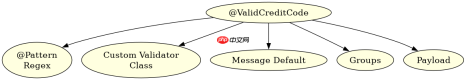
通过定义一个自定义注解 @ValidCreditCode,可以将复杂的正则或算法逻辑封装起来,使 Controller 层的代码更加整洁。该注解内部使用 @Pattern 进行基础格式检查,确保输入字符串长度为 18 位且符合字符规范。
import javax.validation.constraints.Pattern;
import java.lang.annotation.*;

@Target({ElementType.FIELD, ElementType.PARAMETER})
@Retention(RetentionPolicy.RUNTIME)
@Documented
@Constraint(validatedBy = {})
public @interface ValidCreditCode {
    String message() default "统一社会信用代码格式不正确";
    Class>[] groups() default {};
    Class extends Payload>[] payload() default {};
    // 18位,前17位为数字或大写英文字母,最后一位可以是数字或X
    @Pattern(regexp = "^[0-9A-HJ-NPQRTUWXY]{18}$", message = "格式错误")
    @Repeatable(ValidCreditCode.class)
    CreditCodeValidator validator() default @CreditCodeValidator;
}
上述代码展示了注解的基本结构。在实际项目中,通常建议将正则逻辑直接写在 @Pattern 中,或者编写一个独立的 Validator 类来实现更复杂的逻辑(如校验位计算)。这里为了演示清晰,我们采用组合方式。注意:标准的统一社会信用代码校验位算法较为复杂,涉及加权因子和模运算,简单的正则只能保证“看起来像”,不能保证“一定是有效的”。如果需要强校验,必须实现算法验证。
如何在 Service 层实现校验位算法验证
仅靠正则无法防止用户输入看似合法但实际错误的代码。因此,需要在 Service 层或自定义 Validator 中实现基于 GB 32100-2015 的校验位计算逻辑。该逻辑通过前 17 位字符计算出第 18 位校验码,并与输入的第 18 位进行比对。


public class CreditCodeUtil {
    private static final int[] WEIGHTS = {1, 3, 9, 27, 19, 26, 16, 17, 20, 29, 25, 13, 8, 24, 10, 30, 28};
    private static final String CHARS = "0123456789ABCDEFGHJKLMNPQRTUWXY";

    public static boolean isValid(String code) {
        if (code == null || code.length() != 18) return false;
        String upperCode = code.toUpperCase();
        if (!upperCode.matches("^[0-9A-HJ-NPQRTUWXY]{17}[0-9A-HJ-NPQRTUWXYX]$")) return false;

        int sum = 0;
        for (int i = 0; i <p>这段工具类代码实现了核心的校验算法。它首先检查长度和字符集,然后利用预定义的权重数组 <code>WEIGHTS</code> 对前 17 位进行加权求和。最后取模 31,映射到字符集 <code>CHARS</code> 中得到期望的校验位。如果输入的最后一位与计算结果一致,则返回 true。将此方法集成到自定义 Validator 的 <code>isValid</code> 方法中,即可完成从格式到语义的全方位校验。</p><h2>当输入包含小写字母时程序如何处理</h2><p>在实际业务场景中,用户可能输入全小写的统一社会信用代码。程序应当具备容错能力,自动将其转换为大写后再进行校验。如果在自定义 Validator 中没有做大小写转换,直接使用 <code>@Pattern</code> 的正则 <code>^[0-9A-HJ-NPQRTUWXY]{18}$</code> 会导致小写输入被判定为无效。因此,最佳实践是在校验逻辑的最开始调用 <code>toUpperCase()</code>,确保后续的正则匹配和算法计算都在统一的大小写环境下进行,避免因大小写问题导致的误判。</p>