






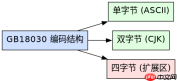
gb18030 是中国国家标准的单字节、双字节和四字节混合编码方案,用于覆盖包括繁体中文及少数民族文字在内的所有字符。在 java 中,它对应 "gb18030" 字符集名称,支持从 ascii 到 cjk 统一汉字及扩展区的完整映射。
Java 中如何获取 GB18030 的 Charset 实例
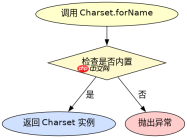
通过 Charset.forName("GB18030") 可以直接获取该编码的实例。由于它是 JDK 内置支持的编码,无需额外引入库即可使用。
import java.nio.charset.Charset;

public class Gb18030Demo {
    public static void main(String[] args) {
        Charset cs = Charset.forName("GB18030");
        System.out.println(cs.name());
        System.out.println(cs.aliases());
    }
}
运行结果:
GB18030
[gb18030, gb18030-1, gb18030-2, gb18030-3]
GB18030 与 UTF-8 的转换差异
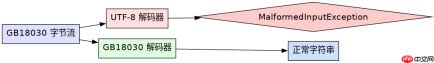
将 GB18030 编码的字节流转换为字符串时,若遇到非法字节序列,默认行为是抛出 MalformedInputException。而 UTF-8 通常允许替换字符。这种差异在处理非标准数据源时尤为明显。

javascript-typescript-typescript-scaffold
下载
你是 TypeScript 项目架构专家,专注于脚手架搭建生产就绪的 Node.js 和前端应用。生成包含现代工具链(pnpm、Vite、Next.js)、类型
import java.nio.charset.Charset;
import java.nio.charset.StandardCharsets;
import java.nio.ByteBuffer;
import java.nio.CharBuffer;
import java.nio.charset.CoderResult;

public class EncodingCompare {
    public static void main(String[] args) throws Exception {
        String text = "测试";
        byte[] gbBytes = text.getBytes(Charset.forName("GB18030"));

        // 尝试用 UTF-8 解码 GB18030 字节
        try {
            new String(gbBytes, StandardCharsets.UTF_8);
        } catch (Exception e) {
            System.out.println("UTF-8 解码失败: " + e.getClass().getSimpleName());
        }

        // 正确用 GB18030 解码
        String decoded = new String(gbBytes, Charset.forName("GB18030"));
        System.out.println("GB18030 解码成功: " + decoded);
    }
}
运行结果:
UTF-8 解码失败: MalformedInputException
GB18030 解码成功: 测试
GB18030 四字节编码的具体表现
当处理超出基本多文种平面(BMP)的字符时,GB18030 会使用四个字节进行编码。例如,某些罕见汉字或符号在 GB18030 中占用 4 个字节,而在 UTF-8 中可能占用 3 或 4 个字节。这种长度差异会影响文件存储大小和网络传输效率。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


