Regex.Match和IndexOf在性能与适用场景上如何抉择?
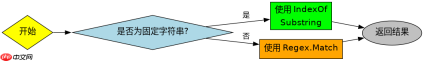
优先使用indexof处理固定字符串定位,仅在需要模式匹配时选择regex.match。对于简单的子串查找或截取,indexof直接调用底层内存搜索算法,执行效率远高于正则引擎的编译与回溯过程。如果输入文本结构复杂且包含可变字符,才考虑引入正则表达式。
using System;
using System.Text.RegularExpressions;

class Program
{
    static void Main()
    {
        string input = "User:Admin,Role:SuperAdmin";

        // 方法一:使用 IndexOf 定位并截取
        int startIndex = input.IndexOf("User:");
        if (startIndex != -1)
        {
            startIndex += 5; // 跳过 "User:" 长度
            int endIndex = input.IndexOf(",", startIndex);
            if (endIndex != -1)
            {
                string result1 = input.Substring(startIndex, endIndex - startIndex);
                Console.WriteLine($"IndexOf Result: {result1}");
            }
        }

        // 方法二:使用 Regex 匹配并提取
        Match match = Regex.Match(input, @"User:(?<val>[^,]+)");
        if (match.Success)
        {
            string result2 = match.Groups["val"].Value;
            Console.WriteLine($"Regex Result: {result2}");
        }
    }
}</val>
上述代码展示了两种实现方式。第一段逻辑通过IndexOf找到起始位置,计算偏移量后再次定位结束符,最终通过Substring获取中间内容。第二段逻辑利用正则表达式User:(?直接捕获目标值。在实际运行中,两者均能正确输出“Admin”,但IndexOf路径避免了正则对象的初始化开销。
当输入数据存在格式波动时,哪种方案更稳健?
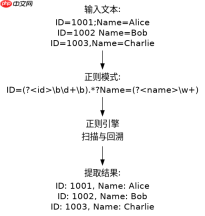
当输入数据的分隔符或前后缀不固定时,IndexOf需要编写大量边界检查代码来应对异常,而Regex.Match可以通过调整模式自动忽略无关字符。此时应牺牲少量性能换取代码的可读性与容错能力。

using System;
using System.Text.RegularExpressions;

class Program
{
    static void Main()
    {
        string[] inputs = {
            "ID=1001;Name=Alice",
            "ID=1002 Name=Bob",
            "ID=1003,Name=Charlie"
        };

        foreach (string input in inputs)
        {
            // 使用正则统一处理不同分隔符
            Match match = Regex.Match(input, @"ID=(?<id>\d+).*?Name=(?<name>w+)");
            if (match.Success)
            {
                Console.WriteLine($"Input: {input} -> ID: {match.Groups["id"]}, Name: {match.Groups["name"]}");
            }
            else
            {
                Console.WriteLine($"Input: {input} -> No Match");
            }
        }
    }
}</name></id>
该示例中,输入数据的分隔符分别为分号、空格和逗号。IndexOf方案必须针对每种情况编写不同的解析逻辑,或者先进行预处理替换。而正则表达式ID=(?中的.*?能够灵活匹配任意非换行字符,从而在一次扫描中提取出稳定的数据字段。这种灵活性在处理日志解析或非结构化文本时尤为关键。
在长文本中频繁调用正则截取会导致什么具体后果?
在长文本中频繁实例化Regex对象会导致显著的性能下降和内存压力。每次调用都会触发正则表达式的编译过程,若未复用RegexOptions.Compiled或静态实例,CPU占用率会随调用次数线性增长。
new Regex()