






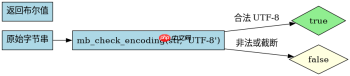
使用 mb_check_encoding 函数并指定编码为 'utf-8' 即可验证字符串是否合法。该函数接收原始字节串和编码名称作为参数,若字符串符合 utf-8 规范则返回 true,否则返回 false。它不会修改原字符串,仅用于校验,适合在数据入库或接口接收时进行前置过滤。
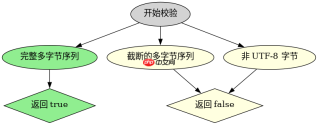
如何区分非法字节与多字节字符截断?
当输入包含非 UTF-8 字节序列(如 Latin-1 混入)或 UTF-8 字符被意外截断时,mb_check_encoding 会直接返回 false。这与 mb_detect_encoding 不同,后者仅猜测最可能的编码,而前者严格遵循 UTF-8 语法树规则,确保每个多字节序列的起始位和延续位都正确匹配。

$raw = "\xc3\xa9"; // valid UTF-8 for 'é'
$invalid = "\xe2\x82"; // truncated UTF-8
$latin = "\xe9"; // Latin-1 'é'

echo mb_check_encoding($raw, 'UTF-8') ? 'Valid' : 'Invalid'; // Valid
echo mb_check_encoding($invalid, 'UTF-8') ? 'Valid' : 'Invalid'; // Invalid
echo mb_check_encoding($latin, 'UTF-8') ? 'Valid' : 'Invalid'; // Invalid
如何处理空字符串或 null 输入?
对于空字符串 '',mb_check_encoding 通常返回 true,因为空串没有违反任何编码规则。但若传入 null,PHP 会将其转换为空字符串进行处理,同样返回 true。在实际业务中,建议先通过类型检查排除 null,避免隐式转换带来的逻辑混淆,确保只有明确的字节串才进入编码校验流程。
$empty = '';
$nullVal = null;

echo mb_check_encoding($empty, 'UTF-8') ? 'Valid' : 'Invalid'; // Valid
echo mb_check_encoding($nullVal, 'UTF-8') ? 'Valid' : 'Invalid'; // Valid (converted to '')
基于程序中某个输入、条件或结果的具体问题
当输入包含 BOM(Byte Order Mark)时,mb_check_encoding 依然认为其是合法的 UTF-8 字符串,因为 BOM 本身是有效的 UTF-8 字节序列(\xEF\xBB\xBF)。如果业务要求去除 BOM,需在校验通过后额外使用 ltrim 或正则替换处理,校验函数本身不关心语义内容,只关心字节结构的合法性。
php免费学习视频:立即使用
踏上前端学习之旅,开启通往精通之路!从前端基础到项目实战,循序渐进,一步一个脚印,迈向巅峰!


