






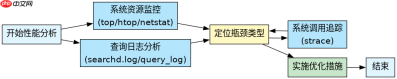
对manticore编译出的http服务进行性能分析,核心在于结合系统级资源监控与manticore内置的查询统计日志。通过`top`或`htop`观察cpu和内存占用,定位是否存在资源瓶颈;同时开启并分析`searchd.log`中的慢查询记录,识别执行耗时过长的sql语句。若需深入排查特定请求,可使用`curl`配合时间参数模拟高并发,并结合linux自带的`strace`追踪系统调用延迟。
如何监控Manticore服务的实时资源消耗?
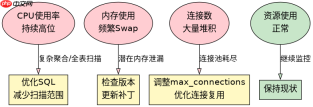
使用Linux系统自带的`top`命令或更友好的`htop`工具即可实时监控。重点关注CPU使用率是否持续接近100%,以及Memory(内存)的使用情况。Manticore作为基于C++的高性能搜索引擎,其内存管理通常较为高效,但若出现频繁的Swap交换,说明物理内存不足,会导致严重的性能下降。
#!/bin/bash
# 监控脚本:monitor_manticore.sh
# 用法: ./monitor_manticore.sh

while true; do
    echo "--- $(date '+%Y-%m-%d %H:%M:%S') ---"
    # 获取Manticore进程ID (假设进程名为 searchd)
    PID=$(pgrep -f searchd | head -n 1)

    if [ -z "$PID" ]; then
        echo "Manticore process not found."
        exit 1
    fi

    # 显示该进程的详细资源使用情况
    ps -p $PID -o pid,ppid,user,%cpu,%mem,rss,vsz,etime,cmd

    # 可选:显示网络连接数,判断是否有大量连接堆积
    netstat -an | grep :9306 | wc -l

    sleep 5
done
运行上述脚本后,观察输出结果。如果`%cpu`长期过高,可能是由于复杂的聚合查询或全表扫描导致。如果`rss`( resident set size )持续增长且不释放,可能存在内存泄漏风险,需检查Manticore版本或配置。此外,通过`netstat`查看端口9306(默认API端口)的连接数,可以判断当前负载是否超过了连接处理能力。
如何分析慢查询日志以优化SQL语句?
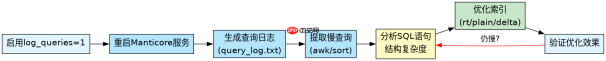
Manticore默认不记录所有查询日志,需要修改配置文件`manticore.conf`启用搜索日志。在`searchd`块中添加`log_queries=1`,然后重启服务。日志文件通常位于`/var/log/manticore/searchd.log`。通过分析该日志,可以找到执行时间超过阈值的查询。

// 示例:manticore.conf 配置片段
searchd {
    listen = 9306
    log = /var/log/manticore/searchd.log
    log_queries = 1
    // 设置慢查询阈值,单位为微秒,这里设为1秒
    query_log = /var/log/manticore/query_log.txt
    query_log_format = sphider
}
配置生效后,定期轮转日志文件并使用`grep`或专用工具分析。例如,使用以下命令提取过去一小时内最慢的10个查询:
# 从query_log.txt中提取慢查询
awk '$4 > 1000000 {print}' /var/log/manticore/query_log.txt | sort -k4 -nr | head -n 10
这里的`$4`代表查询耗时(微秒),大于1000000即1秒。找到这些慢查询后,检查其对应的SQL语句。常见优化手段包括:确保过滤字段(如`@attr`)有索引、避免使用过于复杂的正则表达式、限制返回结果数量(`LIMIT`)、以及使用`GROUP BY`时的适当分桶。对于高频慢查询,考虑调整索引类型,例如将`rt_index`改为`plain_index`并定期重建,或使用`delta+main`架构来平衡写入性能和读取速度。
当遇到特定高延迟请求时,如何使用strace进行系统级诊断?
如果资源监控和日志分析未能直接定位问题,或者怀疑是磁盘I/O或网络延迟导致的单个请求超时,可以使用`strace`跟踪Manticore进程的系统调用。这种方法能揭示底层操作的具体耗时点,如文件读取、socket通信等。
#!/bin/bash
# 诊断脚本:trace_manticore_request.sh
# 用法: sudo ./trace_manticore_request.sh <pid><output_file>

PID=$1
OUTPUT_FILE=$2

if [ -z "$PID" ] || [ -z "$OUTPUT_FILE" ]; then
    echo "Usage: $0 <pid><output_file>"
    exit 1
fi

# 使用strace跟踪指定PID,只关注与时间和I/O相关的系统调用
# -T: 显示每个系统调用的耗时
# -e trace=file,network,time: 仅跟踪文件、网络和时钟相关调用
# -o: 输出到文件
sudo strace -T -e trace=file,network,time -p $PID -o $OUTPUT_FILE &

TRACE_PID=$!
echo "Tracing PID $PID with strace (Trace PID: $TRACE_PID)"
echo "Press Ctrl+C to stop tracing..."

# 等待用户中断
wait $TRACE_PID

# 分析输出文件,找出耗时最长的系统调用
echo "Analysis complete. Analyzing $OUTPUT_FILE..."
grep 'time=' $OUTPUT_FILE | sort -t'=' -k2 -nr | head -n 20</output_file></pid></output_file></pid>
执行此脚本后,`strace`会附加到Manticore进程上,记录所有文件读写和网络通信的耗时。分析输出文件时,重点关注`time=`字段较大的条目。例如,如果某个`read()`或`recvfrom()`调用耗时极长,可能意味着磁盘I/O瓶颈或网络拥塞。如果`open()`或`access()`调用频繁且耗时,可能涉及大量的元数据检查。根据这些线索,可以进一步调整文件系统缓存策略、升级硬件或优化Manticore的索引存储路径(如使用SSD)。注意,`strace`本身会带来一定的性能开销,因此建议在低峰期或测试环境中使用,并在诊断完成后立即停止跟踪。









