






使用 fetch 获取数据后,通过 response.arraybuffer() 读取原始字节流,再结合自定义的 ubjson 解析器将其转换为 javascript 对象。由于浏览器原生不支持 ubjson,必须手动实现二进制数据的解码逻辑,通常涉及处理类型标记、长度前缀和嵌套结构。

如何从 Fetch 响应中获取原始二进制数据
调用 response.arrayBuffer() 是获取 UBJSON 原始字节的关键步骤,它返回一个 ArrayBuffer 对象,保留了服务器发送的精确二进制格式,避免了文本编码带来的损坏。
const response = await fetch('/api/data');
if (!response.ok) {
  throw new Error('Network response was not ok');
}

// 获取原始二进制数据
const buffer = await response.arrayBuffer();
console.log(buffer.byteLength, 'bytes received');
这段代码展示了最基础的获取方式。重点在于不要使用 response.text() 或 response.json(),因为它们会尝试将二进制数据解释为 UTF-8 或 JSON 字符串,导致 UBJSON 的二进制结构被破坏。获取到 buffer 后,可以进一步封装成 DataView 以便进行字节级的读写操作。
如何实现 UBJSON 的基本解析逻辑
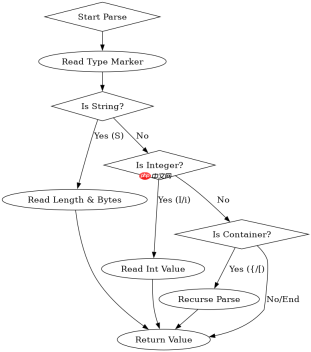
解析 UBJSON 需要遍历 DataView,根据每个元素开头的类型标识符(Type Marker)来决定后续数据的读取方式,例如字符型、整数型或容器型。


class UBJSONParser {
  constructor(buffer) {
    this.view = new DataView(buffer);
    this.position = 0;
  }

  readByte() {
    const value = this.view.getUint8(this.position);
    this.position += 1;
    return value;
  }

  parseValue() {
    const marker = String.fromCharCode(this.readByte());

    switch (marker) {
      case 'S': // String
        const len = this.readUInt32();
        let str = '';
        for (let i = 0; i <p>上述代码提供了一个最小化的解析器原型。它处理了最常见的几种类型:字符串(<code>S</code>)、8位整数(<code>I</code>)、32位整数(<code>i</code>)、对象(<code>{</code>)和数组(<code>[</code>)。实际生产环境中还需要处理布尔值(<code>T</code>/<code>F</code>)、空值(<code>N</code>)、浮点数(<code>D</code>/<code>H</code>)以及大整数等复杂情况。解析器的核心状态机依赖于 <code>position</code> 指针的移动,确保在嵌套结构中正确回溯。</p><h2>如何处理嵌套对象中的键名优化</h2><p>UBJSON 规范允许在对象中使用无引号的短键名(如 <code>#K</code> 后跟单个字符),以节省空间,解析时需特殊处理这种紧凑格式。</p><p>在标准的 UBJSON 对象解析循环中,键名通常以字符串标记 <code>S</code> 开头。但为了优化,规范引入了 <code>#K</code> 标记,表示接下来的单个字节即为键名。这要求解析器在遇到 <code>#K</code> 时,直接读取下一个字节作为键,而不是调用通用的字符串解析函数。例如,若解析器遇到 <code>#K</code>,则执行 <code>const key = String.fromCharCode(this.readByte())</code>,随后直接解析对应的值。这种优化常见于高频通信场景,忽略它会导致解析错位或抛出异常。在实际实现中,应在 <code>parseObject</code> 的方法内增加对 <code>#K</code> 的判断分支,确保键值对的同步读取。</p>
大量免费API接口:立即使用
涵盖生活服务API、金融科技API、企业工商API、等相关的API接口服务。免费API接口可安全、合规地连接上下游,为数据API应用能力赋能!





