






在 java 日志记录中,将日志和指标结合的核心做法是在业务代码中显式调用 metrics 客户端(如 micrometer)的计数器或计时器,同时保留 slf4j 日志用于上下文追踪。具体实现时,通过 aop 切面拦截方法执行,利用 `stopwatch` 或 `timer` 记录耗时并推送至监控系统,并在 `try-catch` 块中捕获异常后记录错误日志和增加错误计数。这样做既能保证监控数据的结构化采集,又能通过日志 id 关联具体的故障现场。

如何通过 AOP 自动统计接口耗时
使用 Spring AOP 可以透明地为服务层方法添加耗时统计功能,无需侵入业务逻辑。核心思路是定义一个自定义注解,在切面中获取方法执行前后的时间戳,计算差值后通过 Micrometer 的 `Timer` 对象记录数据。这种方式适用于所有需要监控响应时间的 REST 接口或内部服务调用。
@Aspect
@Component
public class PerformanceAspect {

    private final Timer timer;

    public PerformanceAspect(MeterRegistry registry) {
        this.timer = Timer.builder("service.execution.time")
                .description("Service execution time")
                .register(registry);
    }

    @Around("@annotation(com.example.PerformanceMonitor)")
    public Object measureExecutionTime(ProceedingJoinPoint joinPoint) throws Throwable {
        return timer.record(() -> {
            try {
                return joinPoint.proceed();
            } catch (Throwable e) {
                log.error("Method {} failed", joinPoint.getSignature().getName(), e);
                throw e;
            }
        });
    }
}
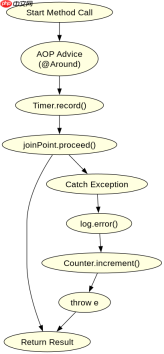
上述代码定义了一个 `PerformanceAspect`,它依赖 `MeterRegistry` 创建全局唯一的 `Timer` 实例。当被 `@PerformanceMonitor` 注解标记的方法被调用时,`timer.record()` 会包裹方法的执行过程。如果方法抛出异常,切面会先记录详细的错误日志,然后重新抛出异常,确保业务逻辑不受影响,但错误依然会被计入监控指标中。
如何在日志中注入 TraceId 以关联指标与日志
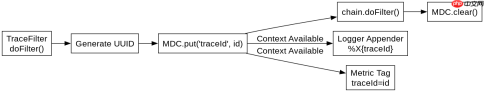
为了在监控面板发现指标异常时能快速定位到具体日志,必须在日志输出中注入全局唯一的 `TraceId`。通常通过 MDC(Mapped Diagnostic Context)实现,在请求入口处生成 UUID 并存入 MDC,在出口处清除。这样,每一行日志都携带了相同的 TraceId,而对应的指标数据也包含该 ID 作为标签(Tag),从而在 Prometheus 或 Grafana 中建立关联。

@Component
public class TraceFilter implements Filter {

    @Override
    public void doFilter(ServletRequest request, ServletResponse response, FilterChain chain)
            throws IOException, ServletException {
        String traceId = UUID.randomUUID().toString();
        try {
            MDC.put("traceId", traceId);
            chain.doFilter(request, response);
        } finally {
            MDC.clear();
        }
    }
}
该过滤器在每个 HTTP 请求开始时生成一个新的 UUID,并将其放入当前线程的 MDC 上下文中。后续的日志框架(如 Logback 或 Log4j2)在配置 Pattern 时引用 `%X{traceId}` 即可将该 ID 打印到日志中。由于指标库(如 Micrometer)也支持为每个指标打上标签,可以在记录指标时将同一个 `traceId` 作为标签传入,实现日志与指标的强关联。
当业务逻辑抛出未捕获异常时指标如何更新
在基于 AOP 的实现中,如果业务代码抛出了未被 `try-catch` 捕获的运行时异常,切面中的 `timer.record()` 仍然会完成计时,但需要在切面中显式处理异常以更新错误计数器。如果不手动处理,默认的指标可能只记录成功调用的耗时,导致错误率指标缺失。正确的做法是在切面的 `catch` 块中调用 `Counter` 增加错误计数,并将异常重新抛出,以保证调用链的完整性。
@Around("@annotation(com.example.PerformanceMonitor)")
public Object measureExecutionTime(ProceedingJoinPoint joinPoint) throws Throwable {
    long start = System.currentTimeMillis();
    try {
        return joinPoint.proceed();
    } catch (Exception e) {
        // 记录错误日志
        log.error("Business logic failed in method: {}", joinPoint.getSignature().getName(), e);
        // 更新错误指标
        Counter.builder("service.errors.total")
               .tag("method", joinPoint.getSignature().getName())
               .tag("exception", e.getClass().getSimpleName())
               .register(meterRegistry).increment();
        throw e;
    } finally {
        // 记录成功或失败的总耗时
        Timer.builder("service.execution.time")
             .tag("status", "error") // 可根据实际状态调整
             .register(meterRegistry)
             .record(System.currentTimeMillis() - start, TimeUnit.MILLISECONDS);
    }
}
这段代码展示了在异常发生时的完整处理流程。首先,`joinPoint.proceed()` 抛出异常进入 `catch` 块。接着,记录详细的堆栈信息以便排查问题。随后,通过 `Counter` 增加特定方法和异常类型的错误计数。最后,在 `finally` 块中记录总的执行耗时,无论成功与否,确保监控数据的完整性。这种处理方式保证了即使业务失败,运维人员也能在监控大盘上看到错误的上升趋势,并通过日志找到根本原因。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


