






Java 异常处理中异常用于控制流程为什么不推荐
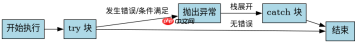
不推荐使用异常来控制程序流程,核心原因是性能开销大、代码可读性差以及违背了异常设计的初衷。在 java 中,抛出和捕获异常涉及栈追踪(stack trace)的生成与展开,这是一个非常昂贵的操作,会显著降低执行效率;同时,将正常业务逻辑隐藏在 try-catch 块中,会使代码结构变得混乱,难以维护。因此,异常应仅用于处理真正的错误情况,而正常流程应通过条件判断或返回值来处理。
异常处理的性能开销具体体现在哪里
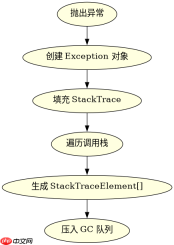
异常处理的性能开销主要体现在对象创建、栈展开和栈回溯三个环节。当抛出异常时,JVM 需要立即捕获当前线程的调用栈,生成包含方法名、行号等详细信息的 StackTraceElement 数组,这个过程比普通的条件判断要慢几个数量级。此外,如果频繁抛出异常,还会增加垃圾回收的压力,因为每个异常对象都是堆内存中的新对象。

import java.util.List;
import java.util.ArrayList;

public class PerformanceTest {
    public static void main(String[] args) {
        List<integer> numbers = new ArrayList();
        for (int i = 0; i <p>运行上述代码,你会发现“异常方式”的执行时间远远长于“条件判断”方式。这证明了在高频调用的场景下,使用异常进行流程控制会导致严重的性能瓶颈。</p>
<h2>基于程序中某个输入、条件或结果的具体问题</h2>
<p>在上面的性能测试代码中,我们使用了 `num % 10 != 0` 作为触发异常的条件。这个具体的输入条件导致每次循环迭代(除了能被10整除的数字)都会抛出一个新的 `RuntimeException` 对象。这种设计不仅没有利用异常的错误处理语义,反而将其当作了一种低效的分支跳转机制。在实际开发中,应该直接使用 `if (num % 10 == 0)` 这样的布尔表达式来判断,这样既清晰又高效。</p></integer>
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


