






wps pdf产品团队11月10日介绍,windows版新增扫描件后台识别能力。打开扫描版pdf后,软件可在本地识别页面文字,让用户直接划选复制或查找关键词,不必每次先手动执行整份文档的文字识别。
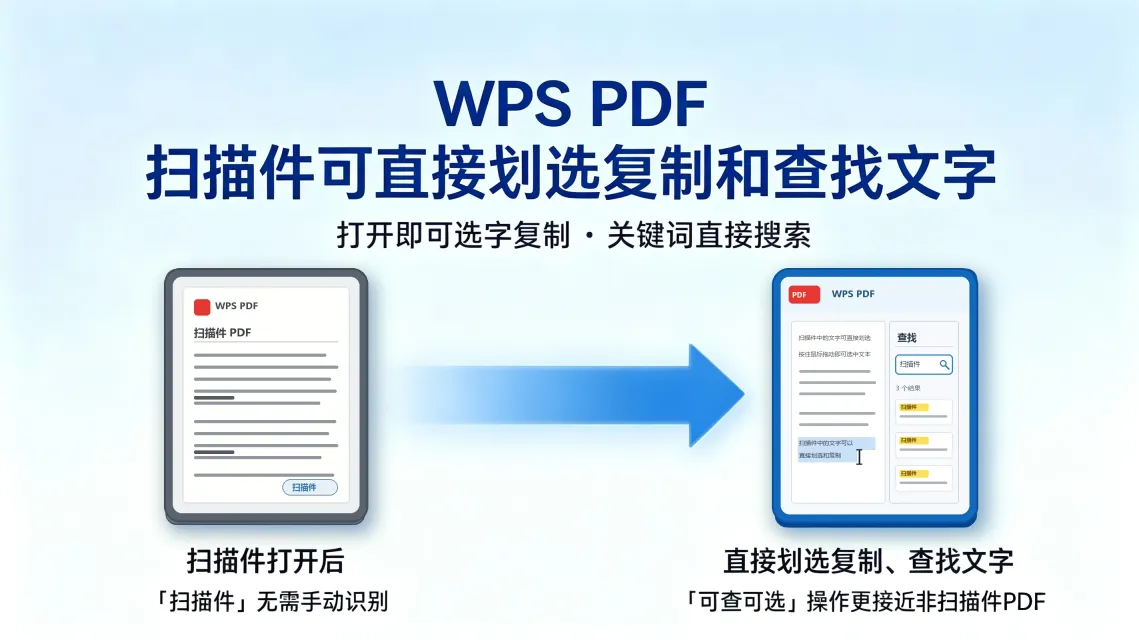
WPS官方扫描件识别功能说明图,非本站操作实测
先覆盖Windows两个版本分支
本次体验要求64位Windows版达到12.1.0.29158,32位版达到12.1.0.29161,或使用更高版本。Mac和鸿蒙版仍列为后续开放范围,不能按Windows的入口判断其他设备已经支持。
离线识别,按阅读位置处理页面
官方说明识别在本地完成,无需将文件上传后等待云端处理,断网时也能使用。程序优先处理当前可见页面;搜索会先显示已经识别的结果,再随其他页面处理完成补充结果。刚打开很长的文件时,不宜把尚未出现全部命中理解为搜索已经完成。
这项能力用于阅读过程中的复制和查找,不会直接把文件改造成双层PDF。需要完整提取、处理模糊或手写文字时,仍应按文件情况使用“扫描件深度识别”或“识别文字”。

设置和性能条件仍需留意
功能入口位于“扫描件—设置与反馈—扫描件划选识别”。官方说明默认开启,但低于所列8核、8GB条件的设备默认关闭;应以实际版本和设备设置为准。TXT导出仍是后续计划,不能把当前的划选复制等同于已新增整份文档TXT导出。


