






nginx 平滑重载(reload)导致 cpu 飙高,通常是因为主进程在生成新的 worker 进程时,将大量已建立的连接通过 unix domain socket 传递给新进程,这一过程涉及大量的内存拷贝和系统调用。排查 worker 堆积的核心在于观察新旧 worker 进程的连接数变化以及系统层面的 accept 队列状态。当旧 worker 正在处理请求而新 worker 尚未完全接管或处理能力不足时,会导致连接在 listen socket 的 backlog 中堆积,进而引发 cpu 因频繁上下文切换或锁竞争而升高。
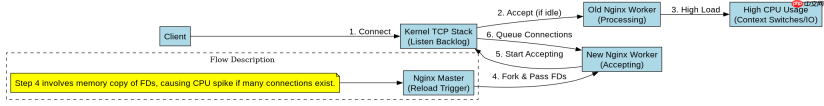
如何监控 Nginx Reload 期间的连接转移与 Worker 状态
要确认是否发生了连接堆积,最直接的方法是监控 Nginx 的状态页面或内部计数器。Nginx 提供了 stub_status 模块,可以实时查看当前活跃的连接数、接受处理的连接数以及读取到的连接数。在 Reload 过程中,你应该观察到总连接数短暂稳定,但 accepts 和 handled 的差值增大,或者新启动的 worker 进程 ID 出现后,其处理的连接数增长缓慢,而旧 worker 仍在高负载运行。
具体做法是开启 stub_status,并在 Reload 前后使用脚本轮询该接口。如果发现有大量连接处于 Reading 或 Writing 状态且持续时间异常长,说明 worker 可能陷入了 I/O 等待或计算瓶颈,导致无法及时从内核接收新连接。此时,内核的 TCP 监听队列(backlog)可能会溢出,导致客户端连接被拒绝或重试,进一步加剧服务器压力。
server {
    listen 80;
    location /nginx_status {
        stub_status on;
        allow 127.0.0.1;
        deny all;
    }
}
预期结果:访问 /nginx_status 返回类似如下内容:
Active connections: 1500
server accepts handled requests
2000 2000 3000
Reading: 5 Writing: 10 Waiting: 1485
在 Reload 期间,若 Active connections 居高不下且 Waiting 数异常低(相对于总连接数),可能暗示 worker 正在忙于处理而非保持空闲等待新连接,需结合系统工具进一步分析。
如何通过系统级指标判断 Accept 队列堆积与 CPU 竞争
除了 Nginx 内部状态,操作系统层面的指标更能反映 worker 堆积的本质原因。CPU 飙高往往伴随着 iowait 或 softirq 的升高,这是因为 Nginx 在传递连接时需要执行大量的文件描述符复制操作。你可以使用 netstat 或 ss 命令查看 TCP 监听队列的积压情况。重点关注 Recv-Q 列,如果该值在 Reload 期间持续增加且不下降,说明内核接收到的连接没有被 Nginx worker 及时 accept 掉,即发生了堆积。
同时,使用 top 或 htop 观察 Nginx worker 进程的 CPU 使用率。如果多个 worker 进程同时呈现高 CPU 使用率(接近 100%),且 %wa(iowait)不高,可能是由于锁竞争或计算密集型任务阻塞。如果 %wa 较高,则可能是磁盘 I/O 或网络栈处理延迟导致的。此外,检查 /proc/net/snmp 中的 TcpExtListenOverflows 和 TcpExtListenDrops,如果这些计数在 Reload 期间增加,直接证明了连接丢弃的发生。

# 查看监听队列积压
ss -lnt | grep :80
# 输出示例:
LISTEN  0  511  *:80  *:*  users:(("nginx",pid=1234,fd=6))
# 注意第二列 (0) 是当前已建立连接数,第三列 (511) 是 backlog 大小
# 如果实际连接数接近 511 且 Recv-Q 不为 0,则发生堆积

# 查看内核 TCP 统计
cat /proc/net/snmp | grep TcpExt
预期结果:ss -lnt 显示 backlog 接近上限。TcpExtListenOverflows 数值在 Reload 瞬间跳变增加。
这表明 Nginx worker 未能及时处理新连接,导致内核层面积压,进而引发重传和 CPU 资源浪费。
基于 worker_connections 限制的具体问题排查
当 Nginx 配置中的 worker_connections 设置过小,或者系统文件描述符限制(ulimit)过低时,Reload 过程中的连接转移会失败或效率极低,直接导致 CPU 飙升和连接中断。这是一个具体的输入条件问题:如果 worker_connections 设置为默认值 1024,而在高并发场景下每个 worker 需要处理数千连接,Reload 时新 worker 无法立即绑定足够的文件描述符来接管旧连接,会导致服务抖动。
排查此问题的方法是检查 Nginx 错误日志(error.log)。如果在 Reload 期间出现 accept() failed (24: Too many open files) 或 epoll_wait() reported that client prematurely closed connection 等错误,说明系统资源已达瓶颈。解决此问题需要同时调整 worker_rlimit_nofile 和 worker_connections,并确保操作系统级别的 fs.file-max 足够大。例如,将 worker_connections 提升至 4096 或更高,并相应增加 file descriptor 限制。
events {
    worker_connections 4096;
    use epoll;
}

# 在 http 块或全局配置中设置
worker_rlimit_nofile 65535;
预期结果:调整后,Reload 过程中错误日志不再出现文件描述符相关报错,stub_status 显示的活跃连接数平稳过渡,CPU 使用率在 Reload 后迅速回落至正常水平。这验证了资源限制是导致堆积和 CPU 高的根本原因之一。


