






linux 中 nginx 平滑重载后连接数异常下降,通常是因为客户端(如浏览器或负载均衡器)在 tcp 连接建立过程中检测到服务端 ip 地址发生变化,从而主动重置了连接。排查的核心在于确认 nginx 是否发生了 ip 漂移、dns 缓存是否导致客户端指向了新实例,以及操作系统内核参数对半开连接的处理策略。

Nginx 配置变更是否触发了 IP 地址变化
如果 Nginx 的 `nginx.conf` 中修改了监听端口、绑定了新的 IP 地址,或者使用了动态 DNS 解析上游服务,平滑重载(Reload)会导致旧的 worker 进程退出,新的 worker 进程启动并绑定新的 socket。此时,如果客户端通过 DNS 解析到的 IP 地址发生了变化,或者负载均衡器后端健康检查发现旧节点不可用而切换流量,客户端现有的长连接会因目标 IP 不匹配而断开。
server {
    listen 80;
    server_name example.com;

    location / {
        proxy_pass http://backend_pool;
    }
}

upstream backend_pool {
    server 192.168.1.10:8080;
    server 192.168.1.11:8080;
}
上述配置中,如果 listen 80 没有指定具体 IP,Nginx 会监听所有可用接口。若服务器有多个网卡或 IP 别名,重载后可能绑定到不同的主 IP。检查 ss -tulnp | grep nginx 的输出,对比重载前后的监听地址。如果 IP 变了,客户端连接自然中断。
DNS 缓存与负载均衡器健康检查的影响
当 Nginx 作为反向代理时,客户端通常通过域名访问。如果 Nginx 部署在多个节点上,且使用 DNS 轮询或外部负载均衡器分发流量,平滑重载可能导致某个节点短暂不可用。负载均衡器的健康检查间隔如果设置过长,可能在 Nginx 重启期间仍向该节点发送新请求,导致连接失败。同时,客户端本地的 DNS 缓存可能未及时更新,指向了已停止服务的旧实例。

# 检查 Nginx 进程状态
ps aux | grep nginx

# 查看当前活跃连接数
ss -s

# 检查系统日志中的连接错误
tail -f /var/log/nginx/error.log | grep "connect() failed"
执行 ps aux | grep nginx 确认 master 和 worker 进程数量是否正常。如果 worker 进程数量减少,说明重载未完全成功。查看 /var/log/nginx/error.log 中是否有大量 connect() failed 或 upstream timed out 错误,这些错误表明后端连接建立失败,可能是由于上游服务器 IP 变化或网络路由问题。
基于 TCP 半开连接队列的排查
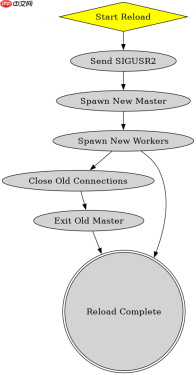
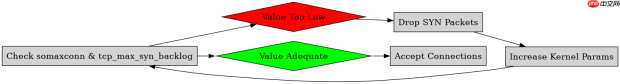
在平滑重载过程中,Nginx 的 master 进程会通知 worker 进程优雅退出,但不会立即关闭已有的连接。然而,如果客户端在 Nginx 处理完响应前就关闭了连接,或者网络中间设备(如防火墙)超时丢弃了半开连接,可能会导致连接数看似下降。此外,Linux 内核的 tcp_max_syn_backlog 和 somaxconn 参数如果设置过小,在高并发重载场景下可能丢弃 SYN 包,导致新连接无法建立。
# 查看内核 TCP 参数
sysctl net.ipv4.tcp_max_syn_backlog
sysctl net.core.somaxconn

# 调整参数示例
sudo sysctl -w net.core.somaxconn=65535
sudo sysctl -w net.ipv4.tcp_max_syn_backlog=65535
检查 net.core.somaxconn 的值,默认通常为 128 或 1024。如果 Nginx 配置的 listen ... backlog 值大于此内核参数,部分连接会被内核丢弃。确保内核参数足够大以支持高并发。同时,监控 netstat -an | grep SYN_RECV 的数量,如果该值异常高,说明存在 SYN 洪水攻击或连接积压问题,而非 Nginx 自身故障。





