






在灰度发布中应用 ip_hash 负载均衡的核心做法是:将灰度服务器与生产服务器划分到不同的哈希环区间,利用 ip 地址的哈希值分布特性,使特定比例的流量自动路由至灰度节点。具体实现时,需在 nginx 配置中为灰度组设置 weight 参数,通过调整权重比例来控制进入灰度环境的流量百分比,同时保持同 ip 的请求始终落在同一组内,确保会话一致性。
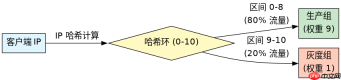
如何配置 Nginx 实现基于权重的流量切分
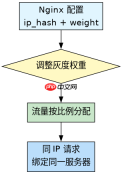
要实现流量切分,需要在 upstream 块中定义两组服务器,一组为生产环境,另一组为灰度环境,并分别指定不同的权重。Nginx 的 ip_hash 算法会根据客户端 IP 计算哈希值,然后映射到整个服务器的加权总和中。通过调整灰度组的权重,可以精确控制落入该组的流量比例。例如,若希望 10% 的流量进入灰度,可将灰度组权重设为 1,生产组权重设为 9,总权重为 10,哈希值落在前 1 个区间的请求将被分发至灰度服务器。
upstream backend {
    ip_hash;
    server 192.168.1.10:8080 weight=9; # 生产环境
    server 192.168.1.11:8080 weight=1; # 灰度环境
}
上述配置中,ip_hash 确保了来自同一 IP 的请求总是被转发到同一台服务器,避免了会话丢失问题。权重设置决定了流量分布的比例。当灰度版本需要扩大测试范围时,只需增加灰度组的权重即可,无需重启服务或修改客户端代码。这种配置方式简单且有效,适用于大多数基于 IP 识别的灰度场景。
如何处理灰度期间后端服务的健康检查与故障转移
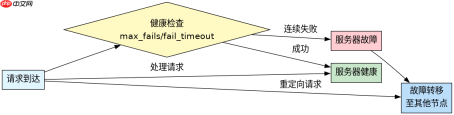
在灰度发布过程中,必须确保灰度服务器的健康状态能被实时监测,并在出现故障时自动将流量切换回生产环境。Nginx 提供了被动健康检查机制,可通过 max_fails 和 fail_timeout 参数实现。当灰度服务器连续失败次数超过阈值时,Nginx 会将其标记为不可用,并将后续请求转发至其他可用服务器。这一机制保障了灰度期间的系统稳定性,防止因灰度版本缺陷导致大面积用户受影响。

upstream backend {
    ip_hash;
    server 192.168.1.10:8080 weight=9 max_fails=3 fail_timeout=30s;
    server 192.168.1.11:8080 weight=1 max_fails=3 fail_timeout=30s;
}
在上述配置中,max_fails=3 表示如果某台服务器连续 3 次请求失败,则在其后的 fail_timeout=30s 时间内不再向其发送请求。这为灰度服务器提供了自我恢复的时间窗口,同时也保护了生产环境不受异常流量的冲击。结合 ip_hash 的粘性特性,即使发生故障转移,同一 IP 的用户仍会被引导至健康的服务器,维持体验连续性。
当灰度服务器权重调整为 0 时流量如何分配
当灰度服务器权重被设置为 0 时,所有流量将完全路由至生产服务器,灰度环境暂时脱离流量。此时,ip_hash 算法仅在生产服务器构成的哈希环中进行映射,灰度节点虽仍在配置中,但不会接收任何新请求。这一特性常用于灰度测试结束后的平滑下线阶段,或临时暂停灰度任务以进行问题排查。权重为 0 的节点在哈希计算中被忽略,确保流量不浪费在不可用的实例上。


