






在synaplan中,上传成功不等于文件已经进入可搜索知识库。文档需要经过内容提取、切块和向量化;图片、音频、视频还有单独的描述处理。构建知识库时先选对处理等级,再检查搜索权限和实际引用结果。
文档选vectorize,而不是只存文件
在Library上传文档时,store只保存文件,extract只提取文本而不生成向量,vectorize完成提取、切块与索引,适合常规RAG检索。full目前虽然执行提取与向量化,但上传时的AI处理仍返回未实现状态,不能理解为额外自动完成所有分析。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
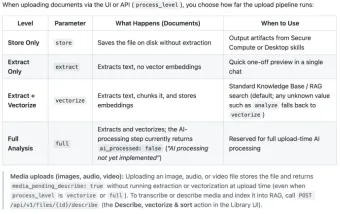
Synaplan原始文档中的处理等级与媒体追加索引规则
媒体文件需要再执行描述与索引
图片、音频和视频上传后会返回media_pending_describe状态,即使指定vectorize或full,也不会在上传阶段自动完成提取和向量化。应使用Library中的Describe, vectorize & sort动作,或调用对应文件的describe接口。
POST /api/v1/files/{id}/describe
先用已知内容验证召回
选一份内容明确的文档,完成处理后用其中确实存在的问题查询,检查答案引用是否指向对应内容。默认存储为MariaDB 11.8及以上的VECTOR;切换到Qdrant时,文档说明提供关键词BM25与向量混合搜索,不能把两个后端的能力写成完全相同。
“可查看”不等于可用于搜索
文件默认私有。共享知识文件夹或聊天文件后,需要Can use或更高权限,才会加入对应的搜索范围。Can view允许浏览Library,却不会让该文件的内容进入RAG检索。
如果用户能打开文件但搜索不到,先核对是否完成向量化、是否属于文档或待描述媒体、是否具有可使用的共享权限,再检查模型及后端状态。这里整理的是配置检查顺序,不把未核实的故障当成高频报错。





