






muse ember的长上下文费用按整次请求的输入规模分档,不是只对超过20万token的部分加价。做批量文档处理或保留长对话历史时,应先确认当前请求落在哪一档,再分别计算普通输入、缓存输入和输出。
先判断输入是否超过20万Token
输入不超过20万Token时,每百万普通输入为0.10美元、缓存输入为0.004美元、输出为0.50美元。超过20万后,这三项分别变为0.30、0.012和1.50美元,整个请求都使用高档价格。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
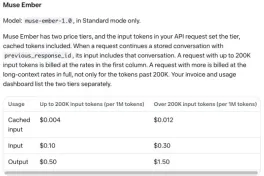
Meta官方Muse Ember两档Token价格与整次请求计费规则
缓存和旧对话也参与档位判断
缓存前缀虽然单价较低,仍计入输入总量。通过previous_response_id继续保存的对话时,已有对话也算本次输入,不能只统计最新一条消息。
按三部分分别计算
请求费用 = 非缓存输入Token / 1,000,000 × 对应输入单价
         + 缓存输入Token / 1,000,000 × 对应缓存单价
         + 输出Token / 1,000,000 × 对应输出单价
例如一条没有缓存的请求使用10万输入、1万输出Token,按低档计算为0.01+0.005,即0.015美元。若使用25万输入、1万输出,则整次使用高档,为0.075+0.015,即0.09美元。示例仅用于演示算式,不包含工具或其他服务费用。

额度和其他功能费用单独核对
官方将Muse Ember列为Standard模式,没有可切换的Contributor API变体。使用web_search等另行计费工具时,还需查看对应费用;不要将单纯的模型Token预算视为完整账单。
模型上下文上限不等于免费额度。保存实际usage、缓存命中和对应计费档位,才能把预算与账单对应起来;未掌握前次请求数据时,不凭总字数猜测费用已经下降。





