






在 docker swarm 中,给更新中的服务设置健康检查机制的核心做法是配置 healthcheck 指令并配合 update_config 参数。通过定义具体的检测命令、间隔时间和超时阈值,swarm 调度器会在滚动更新期间自动验证新容器是否就绪,从而确保服务的高可用性。
如何配置基础的健康检查指令
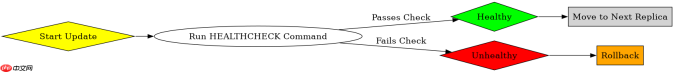
要启用健康检查,需要在服务的 Dockerfile 或 docker-compose.yml 文件中添加 HEALTHCHECK 指令。该指令定义了运行在容器内部的检测脚本或命令,以及检测的频率和容错次数。当 Swarm 启动新版本的容器时,它会等待该容器进入 healthy 状态后才继续推进更新流程。

version: '3.8'
services:
  web:
    image: nginx:latest
    deploy:
      update_config:
        parallelism: 1
        delay: 10s
        order: start-first
      restart_policy:
        condition: on-failure
    healthcheck:
      test: ["CMD", "curl", "-f", "http://localhost"]
      interval: 30s
      timeout: 10s
      retries: 3
      start_period: 40s
上述配置中,test 字段指定了使用 curl 检查本地 HTTP 服务。如果 curl 返回非零退出码,则视为失败。interval 控制检测频率,timeout 限制单次检测的等待时间,retries 允许连续失败三次才标记为不健康。start_period 给予容器启动缓冲期,防止因启动慢被误判为故障。
如何结合滚动更新策略进行验证
健康检查必须与 deploy.update_config 协同工作才能生效。Swarm 默认采用滚动更新模式,即一次更新一个或多个副本。如果没有健康检查,Swarm 可能在新容器尚未完全准备好时就停止旧容器,导致服务中断。通过设置 parallelism 和 order,可以精确控制更新过程中的流量切换逻辑。


version: '3.8'
services:
  api:
    image: my-api:v2
    deploy:
      update_config:
        parallelism: 2
        delay: 5s
        failure_action: rollback
        monitor: 60s
        max_failure_ratio: 0.1
        order: stop-first
    healthcheck:
      test: ["CMD-SHELL", "wget -q --spider http://localhost/health || exit 1"]
      interval: 15s
      timeout: 5s
      retries: 2
      start_period: 30s
在此示例中,failure_action: rollback 是关键配置。如果新容器在 monitor 指定的时间内未能通过健康检查,或者失败率超过 max_failure_ratio,Swarm 将自动回滚到上一个稳定版本。order: stop-first 表示先停止旧容器再启动新容器,这通常用于无状态服务;而 order: start-first 则先启动新容器,待其健康后再停止旧容器,适用于有状态或需要保持连接的服务。健康检查的结果直接决定了这一切换过程是否安全。
基于 start_period 和 monitor 的具体行为分析
在实际部署中,start_period 和 monitor 是两个容易被忽视但至关重要的参数。start_period 定义了容器启动后,健康检查开始计数前的宽限期。在这段期间内,即使健康检查失败,也不会计入 retries 次数。这对于启动较慢的应用(如加载大型数据库连接池)非常有用,避免了因启动慢导致的误回滚。
monitor 参数则定义了 Swarm 在每次更新步骤后观察新容器状态的总时长。如果在 monitor 时间内,新容器始终未达到 healthy 状态,Swarm 会判定更新失败。这两个参数共同构成了一个动态的评估窗口:start_period 保护启动阶段,monitor 保护整个更新周期。开发者应根据应用的实际启动时间和业务逻辑敏感度来调整这两个值,以确保更新的鲁棒性。


