





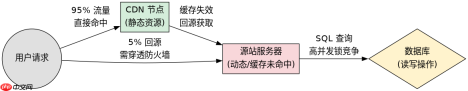
面对日均千万访问量的网站,评估带宽的核心在于区分“静态资源”与“动态交互”,并引入 cdn 进行流量分流。直接购买同等规模的物理带宽不仅成本极高,且极易在业务高峰期出现拥塞。正确的做法是基于 qps(每秒查询率)和平均响应包大小进行数学推导,并结合 cdn 的命中率来反推源站压力。
流量构成与带宽拆解
日均千万访问量(PV)意味着系统需要处理巨大的并发请求。假设用户分布均匀,一天有 86400 秒,平均每秒请求数约为 115 QPS。但在实际业务中,流量具有明显的波峰波谷特征,通常按 10 倍甚至更高的峰值系数来计算带宽。我们需要将请求分为两类:一类是图片、CSS、JS 等静态资源,另一类是需要后端逻辑处理的动态接口。
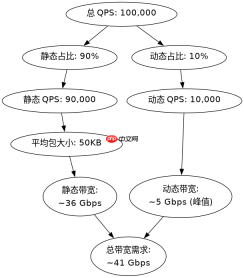
以某电商大促场景为例,假设峰值 QPS 达到 10 万。通过架构设计,90% 的静态资源由 CDN 节点直接返回,仅 10% 的动态请求(如下单、登录)回源至源站。若平均每个请求的响应大小为 50KB(包含 HTML 头、JSON 数据及少量内联资源),则源站需处理的带宽为:10,000 QPS × 50KB × 8 bits = 4 Gbps。考虑到网络抖动和业务突发,通常需预留 30%-50% 的冗余,因此源站带宽建议配置在 5-6 Gbps 左右。而 CDN 侧的带宽则由 CDN 厂商承担,其总量可能高达 30-40 Gbps,但这部分费用通常包含在 CDN 套餐或按流量计费中,无需自建机房承载。
源站带宽压测与代码验证
为了准确评估源站所需的带宽上限,不能仅凭理论估算,必须通过模拟真实负载进行压测。以下 Python 脚本使用 `requests` 库模拟高并发请求,测量平均响应时间并推算带宽消耗。该脚本适用于测试 API 接口的吞吐能力。
import requests
import time
import threading

# 配置参数
TARGET_URL = "http://your-api-endpoint.com/data"
NUM_THREADS = 100  # 模拟并发线程数
REQUESTS_PER_THREAD = 50  # 每个线程发送的请求数
TOTAL_REQUESTS = NUM_THREADS * REQUESTS_PER_THREAD

results = []
lock = threading.Lock()

def send_request():
    start_time = time.time()
    try:
        response = requests.get(TARGET_URL, timeout=5)
        end_time = time.time()
        duration = end_time - start_time
        size_bytes = len(response.content)
        with lock:
            results.append({
                'duration': duration,
                'size': size_bytes,
                'status': response.status_code
            })
    except Exception as e:
        print(f"Error: {e}")

# 执行压测
start_total = time.time()
threads = []
for _ in range(NUM_THREADS):
    t = threading.Thread(target=lambda: [send_request() for _ in range(REQUESTS_PER_THREAD)])
    threads.append(t)
    t.start()

for t in threads:
    t.join()

end_total = time.time()
total_duration = end_total - start_total

# 计算结果
successful_requests = [r for r in results if r['status'] == 200]
total_bytes = sum(r['size'] for r in successful_requests)
avg_latency = sum(r['duration'] for r in successful_requests) / len(successful_requests) if successful_requests else 0

# 带宽计算: 总字节数 * 8 / 持续时间 (bps)
bps = (total_bytes * 8) / total_duration if total_duration > 0 else 0
gbps = bps / 1_000_000_000

print(f"总请求数: {TOTAL_REQUESTS}")
print(f"成功请求: {len(successful_requests)}")
print(f"平均延迟: {avg_latency:.4f} 秒")
print(f"总传输数据: {total_bytes / 1_000_000:.2f} MB")
print(f"实测带宽: {bps:.2f} bps ({gbps:.2f} Gbps)")
print("运行方法: pip install requests && python stress_test.py")
运行上述程序后,观察输出的实测带宽值。如果源站在该并发下 CPU 或内存未饱和,但带宽打满,说明瓶颈在网络出口;如果带宽远未达到预期,但响应时间极长,则瓶颈可能在数据库连接池或应用层逻辑。根据实测结果,向上浮动 20% 作为生产环境的带宽采购标准。例如,若压测显示稳定在 4 Gbps,则建议购买 5 Gbps 的带宽实例。
突发流量下的带宽弹性应对
当遭遇秒杀活动或热点事件时,瞬时 QPS 可能瞬间飙升 50 倍以上。此时固定的带宽线路会立即触发运营商的限速策略或云厂商的带宽封顶。解决这一问题的关键在于启用“带宽弹性伸缩”功能,并配合限流降级策略。云服务商通常允许临时提升带宽上限,但会产生高额按天计费费用。同时,必须在网关层实施令牌桶算法限制非核心请求,确保核心交易链路在带宽临界点时仍能维持基本可用。此外,静态资源的预加载和边缘计算缓存也是缓解源站带宽压力的有效手段,通过将计算逻辑下沉至 CDN 边缘节点,可大幅减少回源带宽占用。





