





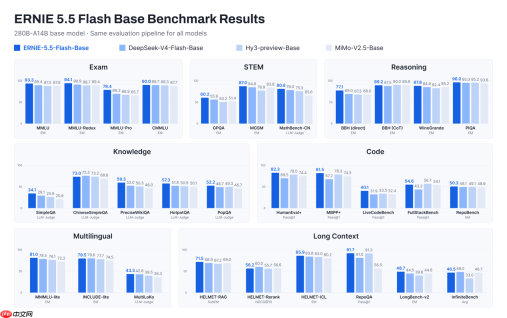
11月5日,百度正式对外开源其最新一代基础大模型——文心5.5 flash base(ernie 5.5 flash base)。该模型采用moe(mixture of experts)架构,总参数规模达2800亿,每处理一个token时动态激活约140亿参数;预训练阶段共消耗33.5万亿个token,支持最高128k的预训练上下文长度,并在微调与推理阶段可扩展至最长100万token的上下文窗口。在知识理解、逻辑推理、数学运算、代码生成、多语言支持及长文本建模等多项权威基准测试中,该模型均刷新同级别参数量模型的最佳性能纪录,综合表现优于deepseek-v4-flash-base、hy3-preview-base、mimo-v2.5-base等竞品模型。
开源地址:https://www.php.cn/link/85ea9e66ee72e87130296f0b79030074
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
随着大模型应用场景从基础文本问答逐步拓展至长文档深度解析、复杂多轮对话以及智能体(Agent)协同任务,模型需处理的信息密度和序列长度持续攀升,对计算资源与显存容量的要求也同步提高。如何在维持甚至增强模型能力的前提下显著提升软硬件资源利用效率,已成为当前大模型研发的核心挑战之一。
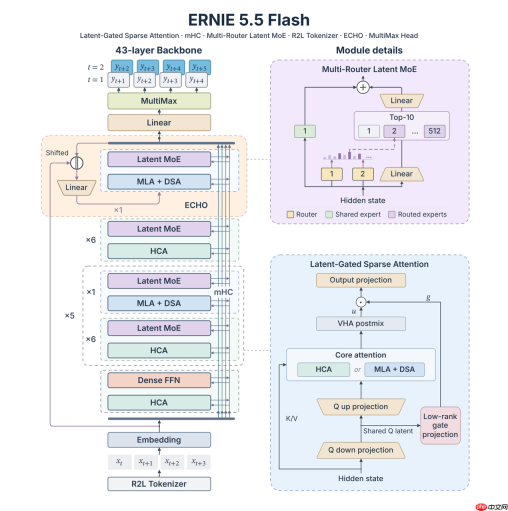
文心5.5 Flash Base以“高效”为设计核心,在注意力机制、专家路由策略及训练目标设计等关键模块进行了系统性重构与多项原创性算法突破。
在注意力机制方面,模型提出 Latent-Gated Sparse Attention 架构,融合混合稀疏注意力(Hybrid Sparse Attention)、低秩门控注意力(Low-Rank Gated Attention)与虚拟头注意力(Virtual Head Attention, VHA)三大组件。其中,通过协同使用HCA(Hierarchical Context Aggregation)与MLA(Multi-Level Attention),不同注意力层被赋予差异化职责:一部分专注于历史信息压缩,另一部分则实现对关键历史位置的细粒度访问;低秩门控注意力借助已有的低维隐状态直接生成门控信号,将门控投影权重参数量压缩75%;而虚拟头注意力VHA则在不增加推理开销的前提下,显著增强模型表达能力与训练稳定性——其计算逻辑可在推理阶段无缝嵌入原生注意力算子中,几乎零额外成本。上述优化共同降低了超长上下文建模的资源消耗,同时保障了对关键语义线索的精准捕捉能力。

百度地图 RTOS SDK(mapsdk-rtos)应用层集成规范与代码生成。帮助应用开发者对接 mapsdk-rtos,开发类似 rtos-mac-simulator(mapAPP)的应用层,包含初始化鉴权、地图组件控制、覆盖物(Marker/Polyline)、检索路线、离线地图、导航、Canvas 适配层等能力。当用户提到:对接 RTOS 地图 SDK、集成 mapsdk-rtos、RTOS 地图初始化、MapComponentApi、AuthLicenseApi、SearchApi、NaviApi
在专家路由机制上,模型引入 Multi-Router Latent MoE 设计,由多个独立训练的轻量级路由器联合决策专家选择路径,从而提升路由评分与专家实际贡献之间的匹配度。相较传统单一路由器方案,该方法有效缓解因单一评分偏差导致的专家误选问题,且在不改变激活专家数量、单次前向计算量及跨设备通信量的前提下,增强了MoE系统的鲁棒性与泛化性。
在训练目标层面,模型创新性地集成 ECHO(Early Contextualized Hidden Output)机制:无需额外引入MTP(Multi-Token Prediction)模块,而是复用模型主干网络最后一层输出,使其直接学习预测后续多个token的分布。这一设计使模型具备更早感知序列演进趋势的能力,显著强化其在推理链构建与代码生成等任务中的表现。值得注意的是,文心5.5 Flash Base仅采用单步ECHO进行预训练,而复用的最后一层还可天然作为投机解码(Speculative Decoding)中的草稿模型,展现出优异的多步外推能力——即便只训练一步,其多步起草质量仍明显超越依赖辅助MTP模块的传统方案。
除模型结构创新外,底层训练基础设施的升级同样关键。文心团队对分布式优化器Muon进行了深度适配优化,并自主研发面向大head维度场景的高性能注意力算子FlashMask-4,全面改善大规模分布式训练过程中的通信效率、显存占用率与GPU计算吞吐。模型能力跃升不仅源于算法设计本身,更离不开高效、稳定、可扩展的训练系统的坚实支撑。
作为大模型技术栈的基石,基座模型不仅承载着预训练阶段所习得的通用语言理解与生成能力,更是下游任务适配、行业模型定制与应用生态构建的重要起点。不同于面向终端用户的成品应用模型,Base模型主要服务于开发者与企业客户,提供高度灵活的微调接口与领域适配空间,支持基于特定业务数据与场景需求,快速构建垂直化、专业化的大模型解决方案。开放高质量基座模型,有助于丰富技术选型生态,大幅降低专业模型研发的训练门槛与工程成本。
当前,大模型领域的竞争正加速迈入新阶段:模型能力、训练效率与场景落地能力三者深度融合、协同发展。伴随推理优化、智能体架构及多模态交互等前沿方向的快速演进,产业界对基座模型的需求已不再局限于单一指标的性能突破,而是转向更高训练效率、更强能力延展性以及更广业务适配性的综合诉求。文心5.5 Flash Base在夯实基础能力的同时,兼顾训练与推理效率的双重提升,为全球开发者与开源社区提供了更具开放性、兼容性与可塑性的技术底座,有力推动大模型技术向多元化能力探索与规模化应用创新纵深发展。


