11月3日,美团官方正式发布全新一代专为长程智能体任务设计的原生多模态大模型——longcat-2.5。该模型是在longcat-2.0基础上完成的一次重大升级,在原生视觉理解能力与智能体编程能力两大核心方向实现全面跃迁,并在多项国际权威评测中与海外顶尖大模型同场比拼,多项关键指标位居榜首。
核心架构与参数规模:1.6万亿总参数驱动端到端工程落地能力
在底层架构层面,LongCat-2.5构建了超大规模参数体系,总参数量达1.6万亿;单次Token推理过程中动态激活约480亿参数,在保障强大推理性能的同时有效兼顾响应效率与资源开销。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
为强化模型处理复杂长程任务的能力,美团研发团队在训练阶段引入了更丰富的长时序行为轨迹数据,并依托大规模长程强化学习策略,显著提升其在大型代码库开发、端到端项目构建等高难度工程任务中的表现。此外,模型首次将视觉信号编码为多粒度离散Token,使主干网络能够以统一Token范式同步处理图像与文本输入。这种“原生视觉感知”与“智能体级编程能力”的深度耦合,不仅推动其在Visual Coding类任务中取得突破性进展,也为创意生成、3D建模等强交互型应用场景提供了坚实技术底座。
在算力支撑方面,该系统针对国产AI芯片环境进行了深度适配优化,重点攻克长上下文训练与W4A4低比特推理的技术难点。通过精细化的训推数值一致性校准及长上下文rollout机制优化,全面支撑大规模长程强化学习的稳定高效运行。

权威基准测评:网页自动化与3D内容生成能力尤为突出
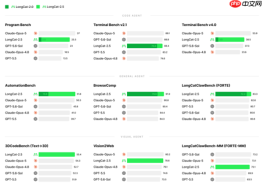
本次综合性能评估覆盖代码生成、通用任务执行、视觉Agent三大方向,共涵盖9项主流评测基准。LongCat-2.5与Claude-Opus-5、GPT-5.6-Sol、GPT-5.5、Claude-Opus-4.8等国际一线大模型展开横向对比,多项细分指标表现亮眼:
在AutomationBench(自动化任务基准)中,LongCat-2.5获得51.8分,超越Claude-Opus-5(50.3分);
在BrowseComp(网页浏览理解与操作基准)中,以91.9分高居榜首;
在3DCodeBench(文本生成3D项目基准)中,斩获55.4分,小幅领先同类竞品。
整体来看,LongCat-2.5在网页交互、自动化流程执行、3D内容生成等典型Agent任务上展现出显著优势;而在传统代码编写、终端指令解析等偏静态任务维度,虽与海外头部模型尚存细微差距,但已稳居全球第一梯队行列。
随着LongCat-2.5的正式发布,美团不仅展现了其在基础大模型研发与具身智能系统构建方面的深厚积累,也标志着国产Agent大模型已具备与全球顶级产品同台竞技、正面对决的实力。目前,官方已全面开放在线体验入口与API接入服务,欢迎广大开发者与行业用户开展深度测试与集成应用。