美团龙猫 longcat 于11月2日正式推出 longcat-2.5,该模型专为长程智能体任务设计,是原生多模态架构的最新迭代,总参数规模达1.6万亿,每 token 动态激活约480亿参数。相比 longcat-2.0,新版本显著增强了原生视觉理解能力与智能体编程能力。目前,模型已开放在线体验及 api 接入服务,模型权重预计将在 github 与 huggingface 平台同步上线。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
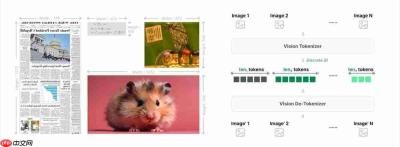
在技术实现上,LongCat-2.5 将视觉输入编码为多层级离散 token,延续 LongCat-Next 的语义对齐编码器结构,并引入残差向量量化(RVQ)机制;通过原生分辨率下的离散化处理与离线视觉 token 预计算,实现视觉与文本输入在统一主干网络中的联合建模;视觉码本 embedding 与主干网络协同训练,并在约3B参数规模的 MoE 架构上验证了视觉与语言语义空间的深度交织效果。
智能体能力构建依托 Agentic RL 训练范式:数据合成流水线自动构建多样化训练任务、可交互仿真环境及可验证测试用例,数据来源涵盖 GitHub 开源项目与美团内部真实场景,采用 fail-to-pass 与 pass-to-pass 双重校验机制保障质量;训练过程中采用 partial rollout 异步策略,有效缓解长尾任务效率瓶颈并抑制样本时效性衰减;同时通过断网模拟、git 历史清空、LLM judge 监督等手段严格约束 reward hacking 行为;跨任务、跨 Scaffold 的混合训练策略进一步提升模型泛化能力。
基础设施层面,LongCat-2.5 针对国产 GPU 单卡显存普遍低于80GB 的现实约束,深度优化超节点并行策略与双重分片 FSDP(Fully Sharded Data Parallel),在长序列监督微调(SFT)任务中,单卡吞吐量相较传统 DDP 基线提升86%。推理阶段采用 W4A4 量化方案,将专家权重与激活值同步压缩至4bit,在保持精度前提下,Prefill 与 Decode 吞吐分别较 W8A8INT8 基线提升43.3% 和42.77%,首 token 延迟(TTFT)与每 token 延迟(TPOT)分别下降15.91% 和19.72%,GMM 算子平均加速达1.73倍。
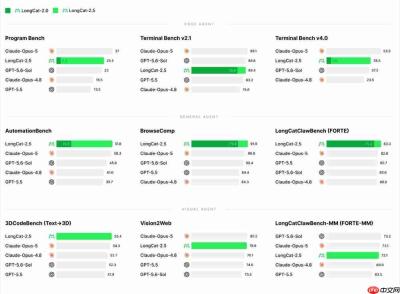
评测结果显示,LongCat-2.5 在多项智能体基准测试中表现优异:Terminal Bench v2.1 与 v4.0 分数分别为88.4 和38.5,AutomationBench 达51.8,BrowseComp 为91.9,Program Bench 得25.5,MCP Atlas 为83.1,3DCodeBench 为55.4;其中 Terminal Bench v4.0 显著超越 GPT-5.6-Sol 的37.3;视觉理解方面,Vision2Web 得分为78.6,MathVision 达96.5。
LongCat-2.5 以原生多模态建模能力与全栈国产算力适配能力切入长程智能体赛道,标志着大模型发展正从单纯参数规模比拼,转向以真实任务效能为核心的竞争新阶段。
详情参见官网技术博客:https://www.php.cn/link/b29f58be9182012bdd9f31c5f07b904d