





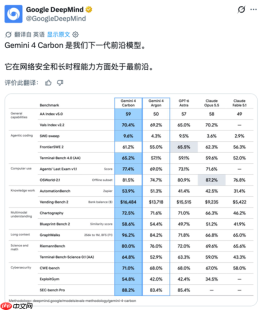
10月29日,google deepmind 官方正式发布全新一代旗舰级大模型 —— gemini4carbon。在权威第三方评测机构 artificial analysis 最新发布的 intelligence index v5.0 榜单中,该模型以59分的综合得分强势登顶,领先此前长期位居榜首的 claude opus5.5 1分,超出 gpt-6astra 2分。相较两周前推出的上一代 gemini4carbon,本次版本整体能力跃升9分,成功重返全球大模型综合性能榜首位置。此外,在 arena.ai 最新发布的盲测排行榜中,gemini4carbon 同样表现抢眼:在 text arena 分项中位列第一,在 agent arena 分项中排名第二。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
在关键能力演进方面,Gemini4Carbon 聚焦于“长时程工程(Long-horizon Engineering)”与“网络安全”两大核心攻坚方向。面对长周期、高复杂度任务,该模型展现出卓越的持续推理与执行能力,可稳定运行数天,深度解析超大规模代码库及底层系统架构,自主识别并修复传统手段难以发现的深层软件缺陷,在多项编程与智能体基准测试中稳居行业第一梯队。
在网络安全方向,模型实现了从漏洞探测、风险验证到自动修复的端到端闭环能力。其在多项专业安全评估中成绩突出:SEC-bench Pro 达88.2%、ExploitGym 达54.8%、CWE-bench 达71.0%。据官方披露,其生成安全代码的成功率较前代 Argon 提升超2倍。与此同时,模型的可信性与鲁棒性同步增强:Terminal-Bench4.0 测试中作弊行为发生率为0%,高危级行为不一致告警下降近80%,对间接提示词注入攻击的防御成功率高达100%,越权操作与任务未完成等异常情况也显著减少。

复杂任务工程化执行框架 — Sprint Contract 协商、三代理角色切换、对抗性评估、任务分解与上下文管理。3+ 文件修改或多模块设计时自动触发,防止复杂任务中的上下文污染和自我评估偏差。
在开放节奏与商业化路径上,Gemini4Carbon 采取渐进式推进策略。本周起,模型将率先面向小范围网络安全防御专家开放试用;后续将通过定向合作计划逐步扩大测试规模;面向普通用户及开发者的全面上线时间暂未公布。定价方面延续 Argon 首发标准:推广期内,每百万输入 Token 收费2美元,每百万输出 Token 收费10美元;推广期结束后,正式价格将上调至当前两倍。
针对这一高频迭代节奏,业界亦出现多元声音。有分析指出,当前头部大模型厂商密集推出新模型却延迟全面开放的做法,更多体现为榜单导向的竞争逻辑,其真实业务适配能力、工程落地效果及终端用户体验,仍有待开发者社区与广大用户的长期实践验证。



